
Kecerdasan buatan (AI) membuat materi belajar untuk ujian spesialis, lalu AI yang sama memeriksa ulang kesalahannya. Jika sudah melewati tahap ini, apakah residen yang menyiapkan ujian spesialis bisa langsung mempercayainya dan belajar dari sana?
Hasil pemeriksaan pada materi ujian spesialis radiologi menunjukkan jawabannya masih “belum, untuk saat ini”. Bahkan pada materi yang dinyatakan lolos pemeriksaan otomatis AI, peneliti tetap menemukan kesalahan serius sekitar 1% yang berpotensi mengaburkan penilaian klinis dokter.
Asan Medical Center Seoul pada tanggal 24 mengumumkan hasil studi yang mengembangkan sistem untuk memproduksi massal materi pendidikan radiologi dengan AI generatif dan menyaring kesalahan secara otomatis, lalu meminta dokter memverifikasinya kembali.
Riset ini dilakukan oleh Prof. Kim Nam-kuk dan peneliti Nam Yu-jin dari Departemen Kedokteran Konvergensi Asan Medical Center Seoul, bersama Prof. Hong Pa dari Departemen Radiologi Samsung Changwon Hospital. Makalah ini dimuat pada edisi terbaru jurnal internasional 〈npj Digital Medicine〉.
Membuat 6.000 kartu kilat sesuai cakupan ujian spesialis
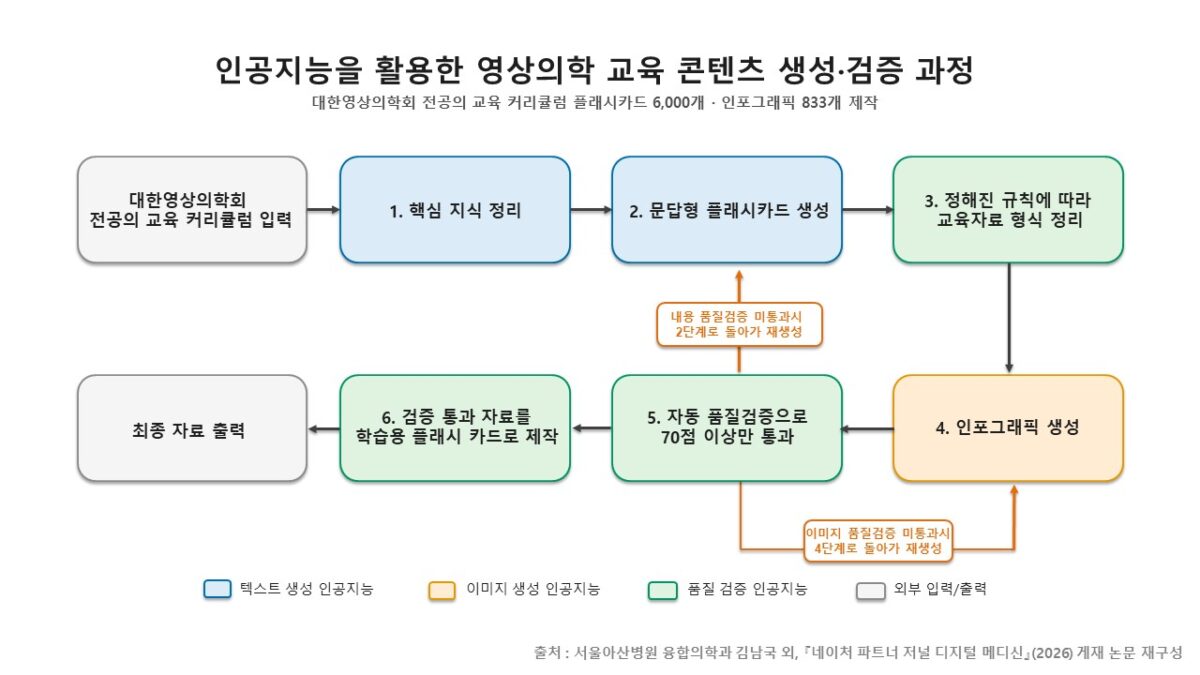
Tim peneliti, berpatokan pada kurikulum pendidikan spesialis dari Korean Society of Radiology, meminta AI menyeleksi pokok-pokok inti yang diperlukan untuk ujian dan menyusunnya menjadi materi belajar.
Pertama, mereka membuat kartu kilat (flashcard) yang terdiri dari pertanyaan dan jawaban. Flashcard adalah materi belajar yang menempatkan pertanyaan di satu sisi dan jawaban di sisi lain untuk mengulang dan menguasai poin-poin inti.
Berikutnya, mereka menyunting isi dan membuat infografik. AI kemudian memeriksa kembali kualitas konten dan gambar; bila tidak memenuhi standar, materi dikembalikan ke tahap sebelumnya untuk dibuat ulang.
Melalui proses ini, dihasilkan 6.000 flashcard dan 833 infografik pada 11 subbidang radiologi.
Yang ingin dipastikan peneliti bukan sekadar seberapa banyak materi yang dapat diproduksi AI. Pertanyaan yang lebih penting ialah sejauh mana materi yang dinilai “tidak bermasalah” oleh pemeriksaan mandiri AI dapat dipercaya dan dipakai dalam pendidikan kedokteran di dunia nyata.
AI memberi “lulus”, tetapi dokter menemukan kesalahan serius 1%
Dari seluruh flashcard, 1.284 di antaranya menjalani verifikasi manusia. Sebanyak 20 dokter—9 residen radiologi dan 11 spesialis—mengecek langsung apakah faktanya benar, apakah layak sebagai materi pendidikan spesialis, dan apakah ada kesalahan yang wajib diperbaiki.
“Kesalahan serius (blocking error)” dalam studi ini bukan sekadar salah ketik atau desain yang canggung. Ini adalah kesalahan fakta yang, bila dipelajari apa adanya, dapat mengarahkan penilaian klinis dokter ke arah yang keliru sehingga harus diperbaiki sebelum digunakan untuk pendidikan. Contohnya termasuk menandai lokasi anatomi secara salah, mengaitkan temuan pada citra dengan penyakit yang tidak relevan, atau menyajikan diagnosis banding yang keliru. Dalam praktiknya, ada pula kasus ketika materi yang dinilai tidak bermasalah oleh AI gagal menunjuk dengan tepat trombus vena yang muncul bersama massa pada ginjal.
Ketika 1.100 penilaian ahli terhadap 980 flashcard yang lolos pemeriksaan otomatis AI dianalisis, ditemukan 11 kasus kesalahan serius seperti ini. Jika dihitung berdasarkan jumlah penilaian, angkanya setara 1 kasus per 100 penilaian.
Artinya, meski AI menilai “tidak ada masalah besar”, saat dokter meninjaunya kembali, masih ada kesalahan yang membuatnya sulit digunakan apa adanya untuk pendidikan.
Sebelum memulai penelitian, tim menetapkan standar untuk menekan kesalahan serius yang terlewat oleh AI hingga di bawah 0,3%. Maksudnya, dari 1.000 penilaian, kasus ketika manusia menemukan kesalahan serius pada materi yang diloloskan AI harus kurang dari 3.
Dalam statistik, kondisi ketika sebenarnya ada masalah tetapi pemeriksaan menilai tidak ada masalah sehingga luput disebut “false negative”. Dalam studi ini, kasus ketika ahli belakangan menemukan kesalahan serius pada materi yang diloloskan AI termasuk kategori tersebut.
Namun, 0,3% bukan standar keselamatan resmi untuk AI pendidikan kedokteran yang ditetapkan pemerintah atau asosiasi profesi. Karena bidang ini belum memiliki ambang toleransi kesalahan yang diakui, tim peneliti menetapkannya sebagai standar penelitian dengan merujuk pada materi bidang medis lain yang terkait keselamatan pasien, seperti kesalahan peracikan obat atau kasus penyakit yang luput terdeteksi dalam pemeriksaan.
Karena itu, angka 1% kali ini tidak bisa diperluas maknanya menjadi “materi medis buatan AI generatif salah 1 dari 100”. Ini adalah hasil evaluasi materi pendidikan spesialis radiologi yang dibuat dengan sistem AI tertentu, menggunakan metode penelitian ini.
Bukan semata masalah “halusinasi” AI: mengapa jawaban salah yang meyakinkan tak tersaring
Lalu, mengapa AI tetap melewatkan kesalahan meski memeriksa ulang materi yang dibuatnya sendiri?
Fenomena ketika AI generatif menghasilkan informasi yang bertentangan dengan fakta namun tampak meyakinkan kerap disebut “halusinasi (hallucination)”. Namun, peneliti menilai sulit menjelaskan seluruh kesalahan yang tersisa dalam studi ini hanya dengan halusinasi AI.
Tim peneliti berulang kali menyempurnakan instruksi yang diberikan kepada AI untuk meningkatkan akurasi pemeriksaan otomatis. Pada tahap verifikasi, AI diarahkan untuk mencari dan merujuk bahan bukti eksternal yang telah diseleksi. Meski begitu, dari 39 kesalahan serius yang ditemukan manusia, AI hanya menangkap 28. Sisanya, 11 kasus, tetap lolos.
Salah satu penyebab utama yang disebut adalah metode verifikasi antarsesama AI. Dalam sistem ini, hasil yang dibuat oleh satu AI diteruskan ke AI pada tahap berikutnya untuk diperiksa, dan pekerjaan berjalan berurutan. Tidak ada struktur di mana beberapa AI saling mengajukan sanggahan atau meninjau ulang keputusan sebelumnya. Jika pada tahap awal terbentuk jawaban salah yang tampak masuk akal, AI pada tahap berikutnya bisa saja menerimanya tanpa curiga.
Yang lebih menonjol adalah “keyakinan” AI. Untuk 11 kesalahan yang luput dan ditemukan ahli, AI pemeriksa otomatis memberi nilai tertinggi baik untuk akurasi maupun kualitas pendidikan. Jadi, kesalahan muncul bukan pada materi yang nyaris tidak lulus, melainkan pada materi yang dinilai tinggi dan dianggap tidak bermasalah oleh AI.
Karakteristik bidang radiologi juga tampaknya berpengaruh. Dari 11 kesalahan yang luput, sekitar tiga perempatnya merupakan kesalahan terkait gambar.
Meski penjelasan teks benar, jika panah menunjuk struktur anatomi yang keliru atau hubungan posisi organ dan pembuluh darah salah, materi tersebut bermasalah sebagai bahan ajar radiologi. Saat ini AI dapat membuat citra medis yang sekilas tampak meyakinkan, tetapi belum mencapai tahap mampu merepresentasikan hubungan anatomi yang rinci secara konsisten akurat.
Pada akhirnya, kesalahan yang terkonfirmasi dalam studi ini sulit dijelaskan dengan satu penyebab. Kemungkinan ada kombinasi faktor: bukan hanya halusinasi AI yang menghasilkan konten keliru, tetapi juga masalah ketika AI lain kembali mempercayai jawaban salah yang tampak meyakinkan, metode verifikasi berurutan yang menyulitkan peninjauan ulang keputusan sebelumnya, serta keterbatasan dalam mengekspresikan struktur halus pada citra medis secara akurat.
Dengan kata lain, jawaban salah yang tampak meyakinkan—baik bagi mata manusia maupun pemeriksaan AI—justru lebih mudah bertahan hingga tahap akhir.
AI sebagai “mata kedua”, tetapi pemeriksaan terakhir tetap oleh manusia
Ada pula temuan menarik. Tenaga medis mula-mula menilai materi tanpa melihat pendapat AI. Setelah itu, mereka memeriksa bagian mana yang ditandai AI sebagai masalah, lalu meninjau ulang materi yang sama.
Hasilnya, jumlah penilaian yang menunjuk kesalahan serius meningkat dari 39 menjadi 54. Skor untuk akurasi materi dan kualitas edukatif juga cenderung menjadi lebih ketat pada penilaian kedua.
Ini menunjukkan kemungkinan AI digunakan bukan untuk menggantikan ahli, melainkan sebagai “mata kedua” yang mendorong manusia memeriksa kembali bagian yang mungkin terlewat.
Namun, tidak bisa dipastikan bahwa kemampuan menemukan kesalahan benar-benar meningkat berkat pendapat AI. Bisa saja penilai menemukan bagian yang terlewat pada penilaian pertama karena meninjau materi yang sama dua kali. Ada pula kemungkinan bahwa fakta bahwa AI menandai masalah membuat penilai menjadi lebih kritis.
Meski pemeriksaan akhir oleh ahli diperlukan, memeriksa semua materi dari awal hingga akhir oleh manusia juga bukan perkara mudah.
Dalam studi ini, waktu yang dibutuhkan dokter untuk meninjau satu flashcard memiliki median 53 detik. Dengan kecepatan ini, untuk meninjau seluruh 6.000 kartu diperlukan sekitar 88 jam. Bahkan jika meninjau 8 jam per hari, tetap memakan waktu sekitar 11 hari.
Pemrosesan otomatis AI juga tidak sempurna. Sebagian flashcard yang dihasilkan mengalami masalah dalam proses sehingga hasil pemeriksaan kualitas otomatisnya sendiri tidak tersimpan.
AI unggul dalam membuat materi pendidikan dalam jumlah besar dalam waktu singkat. Namun, jika seluruh proses diserahkan, kesalahan bisa tetap tersisa. Sebaliknya, jika manusia membuat dan memeriksa materi satu per satu, efisiensi penggunaan AI menurun.
Pada akhirnya, kuncinya adalah di titik mana membagi bagian yang dapat diserahkan kepada AI dan bagian yang wajib diperiksa manusia.
Arah yang diajukan tim peneliti adalah “Human-in-the-loop”. Ini adalah pendekatan di mana ahli terlibat dalam proses kerja AI untuk memeriksa tahap-tahap penting dan hasil akhir. Misalnya, AI menangani pembuatan materi dan pemeriksaan tahap pertama, sementara sebelum digunakan dalam pendidikan nyata, pakar bidang terkait menyaring kesalahan untuk terakhir kalinya.
Prof. Kim Nam-kuk mengatakan, “Melalui penelitian berskala besar, kami membuktikan bahwa verifikasi oleh ahli mutlak diperlukan agar AI generatif dapat dimanfaatkan secara aman di lapangan pendidikan,” seraya menambahkan, “Perlu penelitian berkelanjutan untuk mengelola secara sistematis kesalahan yang luput dari verifikasi otomatis dan menyiapkan standar keselamatan.”
Peneliti Nam Yu-jin mengatakan, “Studi ini sekaligus mengonfirmasi kemungkinan AI generatif memproduksi massal materi pendidikan pencitraan medis, dan menunjukkan bahwa alih-alih menggunakan materi yang dibuat begitu saja, penting untuk menganalisis pada tahap mana kesalahan terjadi serta menjalankan proses penyaringan.”