
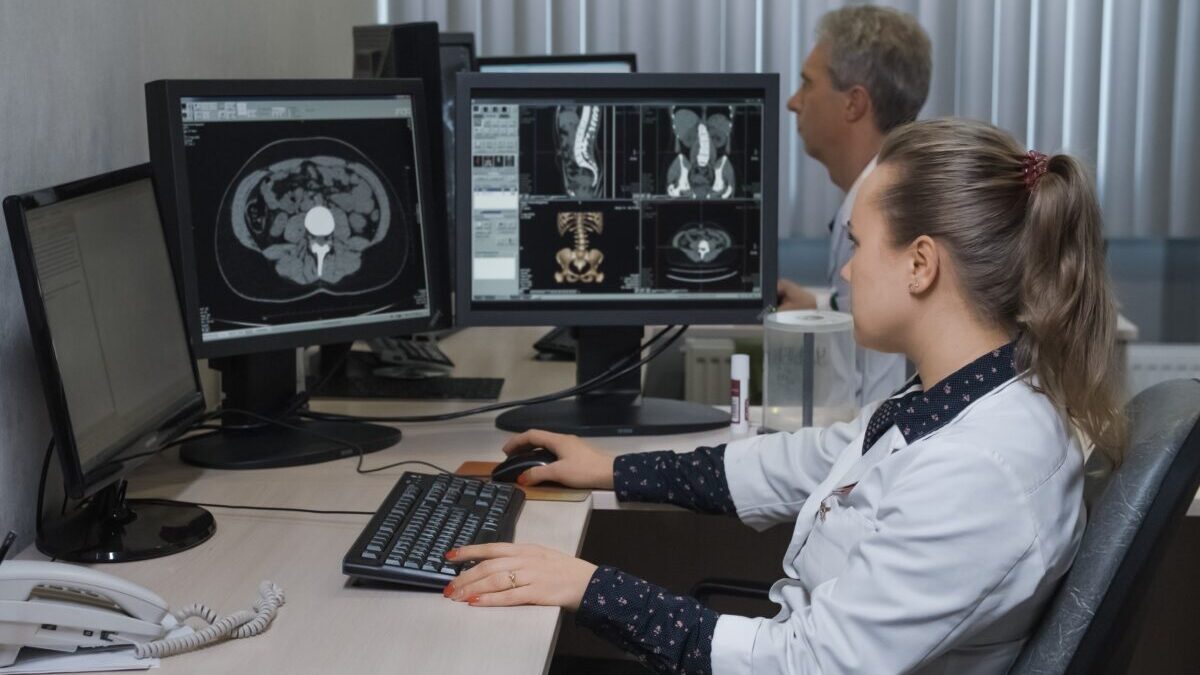
L’intelligence artificielle (IA) peut produire des supports de révision pour l’examen de spécialiste, puis une autre IA peut en contrôler les erreurs. Après ces étapes, un interne qui prépare l’examen peut-il s’y fier et étudier tels quels ces contenus ?
Pour des supports destinés à l’examen de spécialité en radiologie, la réponse est plutôt : « pas encore ». Même parmi les contenus ayant passé la vérification automatique de l’IA, environ 1 % comportaient des erreurs majeures susceptibles d’induire en erreur le jugement clinique d’un médecin.
L’Asan Medical Center de Seoul a annoncé, le 24, les résultats d’une étude : après avoir développé un système permettant de produire en masse des supports pédagogiques de radiologie à l’aide d’une IA générative et d’en filtrer automatiquement les erreurs, l’hôpital a demandé à des médecins de procéder à une nouvelle validation.
L’étude a été menée par Kim Nam-kuk, professeur au département de médecine de convergence de l’Asan Medical Center de Seoul, Nam Yu-jin, chercheuse, et Hong Pa, professeur au service de radiologie du Samsung Changwon Hospital. L’article a été publié dans le dernier numéro de la revue internationale 《npj Digital Medicine》.
6 000 flashcards créées à partir du programme de l’examen de spécialiste
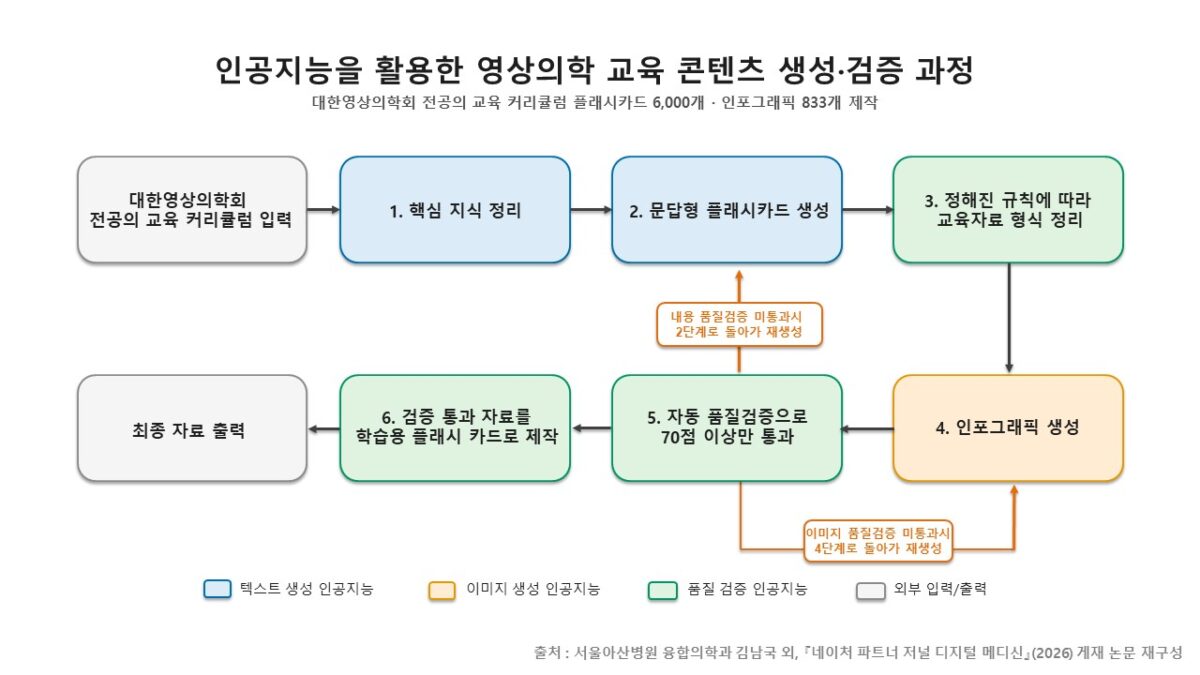
À partir du cursus de formation des spécialistes de la Korean Society of Radiology, les chercheurs ont demandé à l’IA d’extraire les points essentiels nécessaires à l’examen et de produire des supports d’apprentissage.
Ils ont d’abord créé des flashcards composées de questions et de réponses. Une flashcard est un support d’apprentissage qui présente une question sur une face et la réponse sur l’autre, afin de mémoriser les notions clés par répétition.
Ils ont ensuite affiné le contenu et produit des infographies. L’IA a de nouveau contrôlé la qualité du texte et des images ; si les critères n’étaient pas remplis, le contenu était renvoyé à l’étape précédente pour être recréé.
Au terme de ce processus, 6 000 flashcards et 833 infographies ont été produites dans 11 sous-domaines de la radiologie.
Les chercheurs ne cherchaient pas seulement à mesurer la quantité de contenus que l’IA pouvait générer. La question centrale était de savoir jusqu’où l’on peut faire confiance, dans l’enseignement médical en conditions réelles, à des supports que l’IA a elle-même contrôlés et jugés « sans problème ».
L’IA a donné le « feu vert »… mais les médecins relèvent 1 % d’erreurs majeures
Parmi l’ensemble des flashcards, 1 284 ont fait l’objet d’une validation humaine. Vingt médecins — 9 internes en radiologie et 11 spécialistes — ont vérifié directement l’exactitude des faits, l’adéquation en tant que support de formation pour spécialistes et l’existence d’erreurs devant impérativement être corrigées.
Dans l’étude, une « erreur majeure (blocking error) » ne désigne pas une simple faute de frappe ou un design maladroit. Il s’agit d’une erreur factuelle qui, si elle est apprise telle quelle, peut orienter le jugement clinique d’un médecin dans une mauvaise direction et doit donc être corrigée avant toute utilisation pédagogique. Il peut s’agir, par exemple, d’indiquer une localisation anatomique erronée, d’associer à tort une caractéristique visible à l’imagerie à une maladie sans rapport, ou de proposer un diagnostic différentiel incorrect. Parmi les contenus que l’IA avait jugés sans problème, un cas ne parvenait pas non plus à identifier correctement une thrombose veineuse associée à une masse rénale.
En analysant 1 100 évaluations d’experts portant sur 980 flashcards ayant passé la vérification automatique de l’IA, les chercheurs ont identifié 11 cas de ce type d’erreurs majeures. Rapporté au nombre d’évaluations, cela représente 1 cas pour 100.
Autrement dit, l’IA avait conclu à l’absence de « problème majeur », mais une relecture médicale a montré que des erreurs rendant l’usage pédagogique difficile subsistaient.
Avant de lancer l’étude, les chercheurs avaient fixé un objectif : contenir à moins de 0,3 % les erreurs majeures manquées par l’IA. Cela signifie que, pour 1 000 évaluations, il devait y avoir moins de 3 cas où un humain détecte une erreur majeure dans un contenu que l’IA avait laissé passer comme étant sans problème.
En statistique, le fait qu’un problème existe mais que le test conclue à tort à l’absence de problème est appelé « faux négatif (false negative) ». Dans cette étude, cela correspond aux cas où des experts ont découvert tardivement des erreurs majeures dans des contenus validés par l’IA.
Le seuil de 0,3 % n’est toutefois pas une norme officielle de sécurité pour l’IA en éducation médicale fixée par le gouvernement ou une société savante. Dans ce domaine, il n’existe pas encore de seuil d’erreur officiellement reconnu ; les chercheurs ont donc défini un critère de recherche en s’appuyant sur des données d’autres champs médicaux liés à la sécurité des patients, comme les erreurs de préparation de médicaments ou les cas où un examen manque une maladie pourtant présente.
On ne peut donc pas extrapoler ce 1 % en affirmant que « les supports médicaux créés par une IA générative sont faux 1 fois sur 100 ». Il s’agit du résultat d’une évaluation, selon la méthode de cette étude, de supports de formation pour l’examen de spécialiste en radiologie produits par un système d’IA spécifique.
Pas seulement un problème d’« hallucinations »… pourquoi ces réponses fausses mais plausibles n’ont-elles pas été filtrées ?
Pourquoi l’IA a-t-elle laissé passer des erreurs alors même qu’elle contrôlait à nouveau les contenus qu’elle avait produits ?
On appelle souvent « hallucination (hallucination) » le phénomène par lequel une IA générative produit, de manière convaincante, des informations contraires aux faits. Mais il est difficile d’attribuer l’ensemble des erreurs restantes observées dans cette étude aux seules hallucinations de l’IA.
Pour améliorer la précision de la vérification automatique, les chercheurs ont affiné à plusieurs reprises les instructions données à l’IA. Lors de l’étape de validation, ils lui ont demandé de rechercher et de consulter des sources externes sélectionnées. Malgré cela, sur 39 erreurs majeures identifiées par des humains, l’IA n’en a détecté que 28. Les 11 restantes ont été laissées passer.
Parmi les principales causes figure la méthode de validation « entre IA ». Dans ce système, le résultat produit par une IA était transmis à l’IA de l’étape suivante pour être contrôlé, dans une chaîne séquentielle. Il ne s’agissait pas d’une structure où plusieurs IA se contredisent ou réexaminent les décisions précédentes. Si une réponse fausse mais plausible est générée à une étape, l’IA suivante peut l’accepter sans la remettre en question.
Plus frappant encore : la « certitude » de l’IA. Pour les 11 erreurs omises détectées par les experts, l’IA de vérification automatique a attribué la note maximale, tant pour l’exactitude que pour la qualité pédagogique. Les erreurs ne provenaient donc pas de contenus ayant tout juste franchi la barre, mais de contenus que l’IA avait évalués très favorablement.
Les caractéristiques propres à la radiologie semblent aussi avoir joué un rôle. Parmi les 11 erreurs manquées par l’IA, environ les trois quarts étaient liées aux images.
Même si l’explication textuelle est correcte, une flèche pointant vers une structure anatomique sans rapport, ou une relation de position erronée entre un organe et un vaisseau, pose problème pour un support pédagogique de radiologie. Aujourd’hui, l’IA peut générer des images médicales d’apparence plausible, mais elle n’a pas encore atteint le stade où elle reproduit toujours avec précision les relations anatomiques fines.
Au final, les erreurs observées dans cette étude sont difficiles à expliquer par une seule cause. Outre les hallucinations de l’IA, il pourrait s’agir d’un effet combiné : une autre IA qui croit à nouveau une réponse fausse mais plausible, une validation séquentielle qui rend difficile le réexamen des décisions antérieures, et des limites liées à la représentation précise des structures fines de l’imagerie médicale.
En d’autres termes, des réponses fausses mais plausibles — aux yeux des humains comme de l’IA — avaient davantage de chances de survivre jusqu’à la fin.
L’IA comme « deuxième regard »… mais la validation finale reste humaine
Un résultat intéressant est également apparu. Les professionnels de santé ont d’abord évalué les supports sans consulter l’avis de l’IA. Ils ont ensuite vérifié quels points l’IA avait signalés comme problématiques, puis ont réexaminé les mêmes supports.
Le nombre d’évaluations signalant des erreurs majeures est alors passé de 39 à 54. Les notes attribuées à l’exactitude des contenus et à leur qualité pédagogique ont aussi eu tendance à devenir plus strictes lors de la seconde évaluation.
Ce résultat suggère que l’IA pourrait être utilisée non pour remplacer les experts, mais comme un « deuxième regard » incitant à revérifier des points que l’humain aurait pu manquer.
Il reste toutefois impossible d’affirmer que l’avis de l’IA a réellement amélioré la capacité de détection des erreurs. Les évaluateurs ont pu repérer, lors d’une seconde lecture, des éléments manqués la première fois. Le simple fait de savoir que l’IA avait signalé un problème a aussi pu les rendre plus exigeants.
Le besoin d’une validation finale par des experts ne signifie pas non plus qu’il soit simple de faire vérifier, de bout en bout, tous les contenus par des humains.
Dans cette étude, le temps médian nécessaire à un médecin pour examiner une flashcard était de 53 secondes. À ce rythme, vérifier les 6 000 cartes demanderait environ 88 heures. Même à raison de 8 heures par jour, cela représente environ 11 jours.
Le traitement automatique par l’IA n’était pas non plus parfait. Pour une partie des flashcards générées, des problèmes sont survenus pendant le traitement, si bien qu’aucun résultat de contrôle qualité automatique n’a été conservé.
L’IA a l’avantage de produire en peu de temps une masse considérable de supports pédagogiques. Mais si on lui confie l’ensemble du processus, des erreurs peuvent subsister. À l’inverse, si l’humain crée et vérifie chaque contenu un par un, l’efficacité recherchée avec l’IA diminue.
Au final, l’enjeu est de déterminer où placer la frontière entre ce que l’on confie à l’IA et ce que l’humain doit impérativement vérifier.
La voie proposée par les chercheurs est celle du « Human-in-the-loop ». Il s’agit d’un modèle dans lequel des experts participent au processus de traitement par l’IA et valident les étapes clés ainsi que le résultat final. Concrètement, l’IA se charge de la production des supports et d’un premier contrôle, puis, avant toute utilisation pédagogique, un expert du domaine filtre une dernière fois les erreurs.
Kim Nam-kuk a déclaré : « Nous avons démontré, à travers une étude de grande ampleur, que la validation par des experts est indispensable pour utiliser en toute sécurité l’IA générative dans des contextes éducatifs réels », ajoutant qu’« il faut poursuivre les recherches afin de gérer de manière systématique les erreurs que la vérification automatique laisse passer et d’établir des critères de sécurité ».
Nam Yu-jin a déclaré : « Tout en confirmant la possibilité pour l’IA générative de produire en masse des supports pédagogiques d’imagerie médicale, nos résultats montrent qu’il est important, plutôt que d’utiliser tels quels les supports créés, d’analyser à quelle étape et quels types d’erreurs surviennent, puis de les filtrer ».