
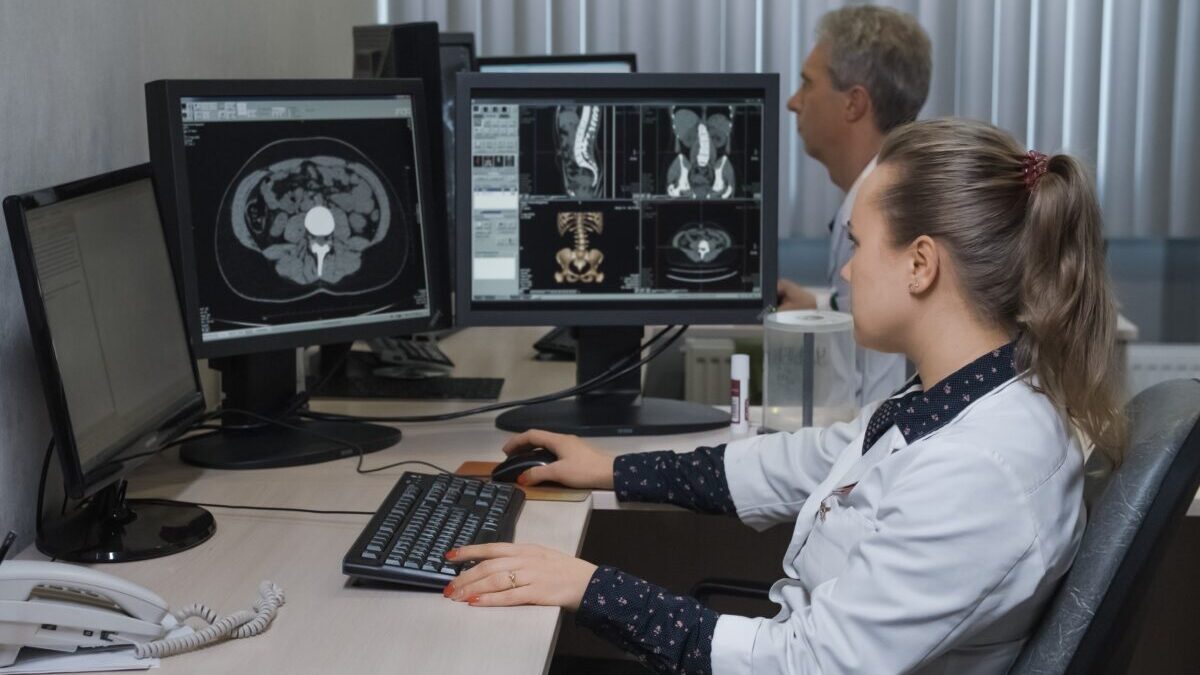
Искусственный интеллект (ИИ) уже способен генерировать учебные материалы для подготовки к экзамену на врача-специалиста и затем автоматически проверять их на ошибки. Можно ли ординатору, готовящемуся к экзамену, безоговорочно доверять контенту, который прошёл оба этапа?
Проверка материалов для экзамена по радиологии показала, что ответ, скорее, «пока нет». Даже среди материалов, которые ИИ после собственной верификации признал пригодными, примерно в 1% случаев обнаружились критические ошибки, способные исказить клиническое суждение врача.
Больница «Асан» в Сеуле 24-го числа сообщила о результатах исследования: после разработки системы, которая массово создаёт учебные материалы по радиологии с помощью генеративного ИИ и автоматически отсеивает ошибки, контент дополнительно перепроверили практикующие врачи.
Исследование провели профессор Ким Намгук и исследователь Нам Юджин из отделения конвергентной медицины больницы «Асан» в Сеуле, а также профессор Хон Пха из отделения радиологии больницы Samsung Changwon. Статья опубликована в свежем выпуске международного научного журнала 《npj Digital Medicine》.
По программе экзамена для специалистов создали 6000 флеш-карт
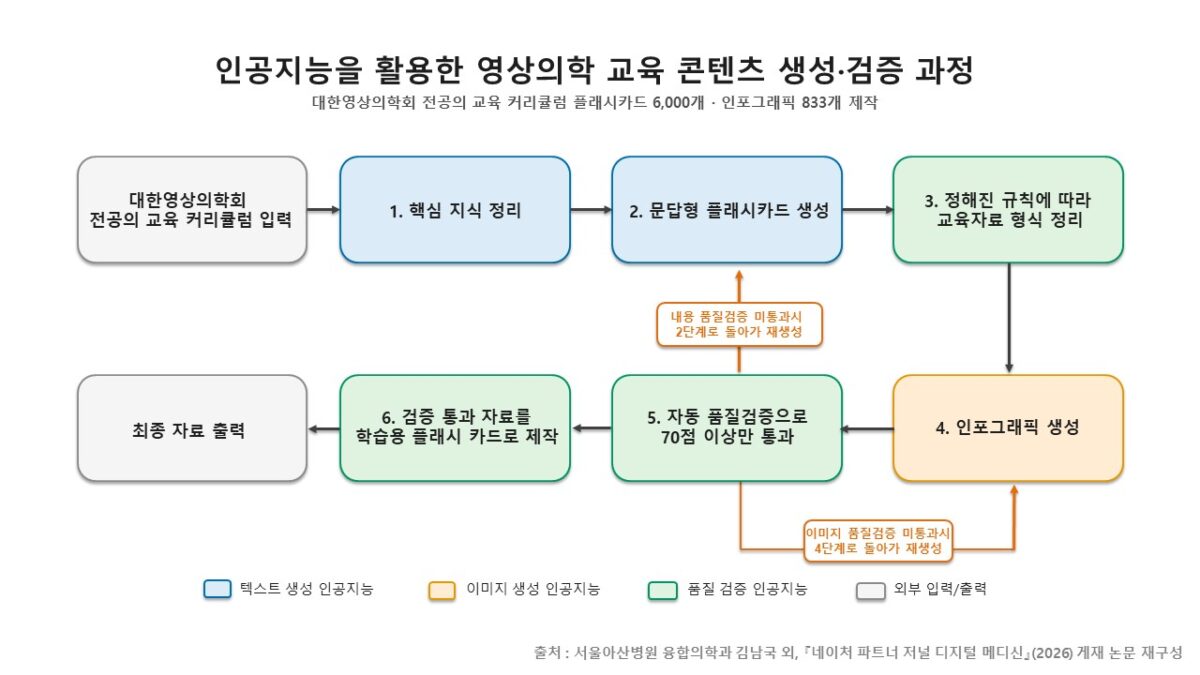
Исследователи, опираясь на программу подготовки специалистов Корейского общества радиологии, поручили ИИ отобрать ключевые темы, необходимые для экзамена, и подготовить учебные материалы.
Сначала были сделаны флеш-карты в формате «вопрос—ответ». Флеш-карта — это учебный материал, где на одной стороне размещён вопрос, а на другой — ответ, чтобы многократно повторять и закреплять ключевые сведения.
Затем содержание отредактировали и подготовили инфографику. ИИ повторно проверял качество текста и изображений; если материал не соответствовал критериям, его возвращали на предыдущий этап и создавали заново.
В результате по 11 поднаправлениям радиологии были созданы 6000 флеш-карт и 833 инфографики.
Исследователи хотели выяснить не только то, сколько материалов способен произвести ИИ. Ключевым оставался другой вопрос: насколько можно доверять в реальном медицинском образовании материалам, которые ИИ сам проверил и признал «без проблем».
ИИ поставил «зачёт», но врач нашёл критические ошибки в 1%
Из всех флеш-карт 1284 прошли проверку человеком. 20 врачей — 9 ординаторов по радиологии и 11 специалистов — напрямую оценили, соответствуют ли материалы фактам, подходят ли они для обучения специалистов и есть ли ошибки, которые необходимо исправить.
Под «критической ошибкой (blocking error)» в исследовании понимают не простую опечатку или неудачный дизайн. Это фактическая ошибка, которую обязательно нужно исправить до использования в обучении, поскольку при изучении «как есть» она может направить клиническое решение врача в неверную сторону. К таким ошибкам относятся, например, неверно обозначенное анатомическое расположение, привязка признака на изображении к не той болезни, а также неправильное указание заболеваний для дифференциальной диагностики. В частности, среди материалов, которые ИИ признал безошибочными, был случай, когда не удалось корректно указать венозный тромбоз, сопровождавший образование в почке.
Анализ 1100 экспертных оценок, выставленных по 980 флеш-картам, прошедшим автоматическую проверку ИИ, выявил 11 таких критических ошибок. Если считать по числу оценок, это примерно 1 случай на 100 оценок.
Иными словами, ИИ решил, что «серьёзных проблем нет», но при повторном просмотре врачами в материалах оставались ошибки, из-за которых их трудно использовать в обучении без правок.
До начала работы исследователи установили критерий: долю критических ошибок, пропускаемых ИИ, нужно удержать ниже 0,3%. Это означает, что при 1000 оценках в материалах, которые ИИ пропустил как «без проблем», человек должен находить критические ошибки менее чем в 3 случаях.
В статистике ситуацию, когда реальная проблема есть, но проверка признаёт её отсутствующей и «пропускает», называют «ложноотрицательным результатом (false negative)». В данном исследовании к этому относятся случаи, когда эксперт позднее обнаруживал критическую ошибку в материалах, прошедших ИИ.
При этом 0,3% — не официальный стандарт безопасности для ИИ в медицинском образовании, установленный государством или профильным обществом. В этой сфере пока нет утверждённых порогов допустимых ошибок, поэтому исследователи задали рабочий критерий, ориентируясь на материалы из других областей медицины, связанных с безопасностью пациентов, — например, на ошибки при приготовлении лекарств или случаи, когда при наличии заболевания проверка его не выявляет.
Следовательно, полученные 1% нельзя расширительно трактовать как утверждение, будто «в медицинских материалах, созданных генеративным ИИ, 1 из 100 неверен». Это результат оценки учебных материалов для экзамена по радиологии, созданных конкретной ИИ-системой и проверенных по методике данного исследования.
Дело не только в «галлюцинациях» ИИ: почему не отсеяли правдоподобные ошибки
Почему же ИИ, повторно проверяя созданные им материалы, всё равно пропустил ошибки?
Распространённое название явления, когда генеративный ИИ правдоподобно «выдумывает» сведения, не соответствующие фактам, — «галлюцинации (hallucination)». Однако в данном исследовании не все оставшиеся ошибки можно объяснить исключительно «галлюцинациями» ИИ.
Чтобы повысить точность автоматической проверки, исследователи неоднократно дорабатывали инструкции, которые задавали ИИ. На этапе верификации ИИ также предлагали находить и использовать отобранные внешние источники доказательной информации. Тем не менее из 39 критических ошибок, обнаруженных человеком, ИИ выявил 28. Оставшиеся 11 прошли без замечаний.
Одной из ключевых причин называют саму схему «ИИ проверяет ИИ». В этой системе результат, созданный одним ИИ, на следующем этапе принимал другой ИИ и проверял его — работа шла последовательно. При этом не было структуры, в которой несколько ИИ спорят друг с другом, выдвигают возражения или повторно пересматривают предыдущие выводы. Поэтому, если на раннем этапе появлялся правдоподобный неверный ответ, ИИ на следующем этапе мог принять его без сомнений.
Ещё более заметной оказалась «уверенность» ИИ. По 11 пропущенным ошибкам, найденным экспертами, автоматический проверяющий ИИ выставил максимальные баллы и за точность, и за образовательное качество. Ошибки обнаружились не в материалах, едва прошедших порог, а в тех, которые ИИ высоко оценил как безупречные.
Вероятно, сказалась и специфика радиологии. Примерно три четверти из 11 пропущенных ИИ ошибок были связаны с изображениями.
Даже если текстовое объяснение верно, для учебного материала по радиологии это проблема, когда стрелка указывает на неправильную анатомическую структуру или неверно показано взаимное расположение органа и сосуда. Сейчас ИИ способен создавать на вид правдоподобные медицинские изображения, но до уровня, когда он стабильно и точно воспроизводит тонкие анатомические взаимосвязи, он ещё не дошёл.
В итоге ошибки, выявленные в этом исследовании, трудно объяснить одной причиной. Вероятно, одновременно могли сыграть роль не только «галлюцинации» ИИ, но и то, что другой ИИ повторно «верит» правдоподобному неверному ответу, последовательная схема проверки, в которой сложно пересматривать предыдущие решения, а также ограничения при точном отображении тонкой структуры медицинских изображений.
Получается, что правдоподобные неверные ответы, выглядевшие убедительно и для человеческого глаза, и для автоматической проверки ИИ, как раз и имели больше шансов «дожить» до финала.
ИИ — «второй взгляд», но финальная проверка всё равно за человеком
Появился и интересный результат. Медики сначала оценивали материалы, не видя мнения ИИ. Затем они смотрели, какие места ИИ отметил как проблемные, и повторно проверяли те же материалы.
После этого число оценок, в которых указывались критические ошибки, выросло с 39 до 54. Баллы за точность материалов и их образовательное качество во второй оценке также в целом становились более строгими.
Это показывает, что ИИ может выступать не заменой эксперта, а «вторым взглядом», который побуждает человека перепроверить то, что могло быть упущено.
Однако нельзя однозначно утверждать, что благодаря мнению ИИ способность находить ошибки действительно улучшилась. При повторном просмотре тех же материалов можно было заметить то, что пропустили в первый раз. Не исключено и то, что сам факт наличия замечаний ИИ сделал оценщика более требовательным.
Даже если финальная экспертная проверка необходима, проверить все материалы человеком от начала до конца тоже непросто.
В этом исследовании медианное время, которое врач тратил на проверку одной флеш-карты, составило 53 секунды. Чтобы в таком темпе просмотреть все 6000, потребуется около 88 часов. Даже при проверке по 8 часов в день это займёт примерно 11 дней.
Автоматическая обработка ИИ тоже оказалась не идеальной. Для части сгенерированных флеш-карт из-за проблем в процессе обработки не сохранились сами результаты автоматической проверки качества.
Сильная сторона ИИ — быстро создавать огромные объёмы учебных материалов. Но если поручить ему весь процесс целиком, ошибки могут остаться. С другой стороны, если человек будет вручную создавать и проверять каждый материал, эффективность использования ИИ снизится.
В конечном счёте ключевой вопрос — где провести границу между тем, что можно поручить ИИ, и тем, что человек обязан проверить.
Предложенный исследователями подход — «human-in-the-loop» (человек в контуре). Это модель, при которой эксперт участвует в процессе работы ИИ и проверяет важные этапы и итоговый результат. Например, ИИ берёт на себя создание материалов и первичную проверку, а перед использованием в реальном обучении специалист по соответствующему направлению в последний раз отсеивает ошибки.
Профессор Ким Намгук заявил: «Мы на большом массиве данных доказали, что для безопасного применения генеративного ИИ в реальной образовательной среде обязательно нужна экспертная верификация», — и добавил: «Необходимо продолжать исследования, чтобы системно управлять ошибками, которые пропускает автоматическая проверка, и выработать критерии безопасности».
Исследователь Нам Юджин отметил: «Мы одновременно подтвердили возможность генеративного ИИ массово производить учебные материалы по медицинской визуализации и показали, что важен не прямой перенос созданных материалов в обучение, а анализ того, на каком этапе и какие ошибки возникают, и процесс их фильтрации».