
AI có thể tạo tài liệu học cho kỳ thi bác sĩ chuyên khoa, rồi tiếp tục tự rà soát lỗi thêm một lần. Nhưng ngay cả khi đã qua bước này, bác sĩ nội trú chuẩn bị thi chuyên khoa có thể tin và học theo nguyên trạng hay không.
Với tài liệu phục vụ kỳ thi bác sĩ chuyên khoa chẩn đoán hình ảnh, câu trả lời vẫn nghiêng về “chưa”. Ngay trong các tài liệu đã vượt qua kiểm tra tự động của AI, nhóm nghiên cứu vẫn phát hiện khoảng 1% lỗi nghiêm trọng, có thể làm lệch nhận định lâm sàng của bác sĩ.
Bệnh viện Asan Seoul ngày 24 cho biết họ đã phát triển một hệ thống dùng AI tạo sinh để sản xuất hàng loạt tài liệu đào tạo chẩn đoán hình ảnh và tự động sàng lọc lỗi. Sau đó, bệnh viện tiến hành nghiên cứu yêu cầu bác sĩ thẩm định lại và công bố kết quả.
Nghiên cứu do Giáo sư Kim Nam-guk và nghiên cứu viên Nam Yu-jin (Khoa Y học Hội tụ, Bệnh viện Asan Seoul) cùng Giáo sư Hong Pa (Khoa Chẩn đoán hình ảnh, Bệnh viện Samsung Changwon) thực hiện. Bài báo đăng trên số gần đây của tạp chí quốc tế 〈npj Digital Medicine〉.
Tạo 6.000 thẻ flashcard theo phạm vi thi chuyên khoa
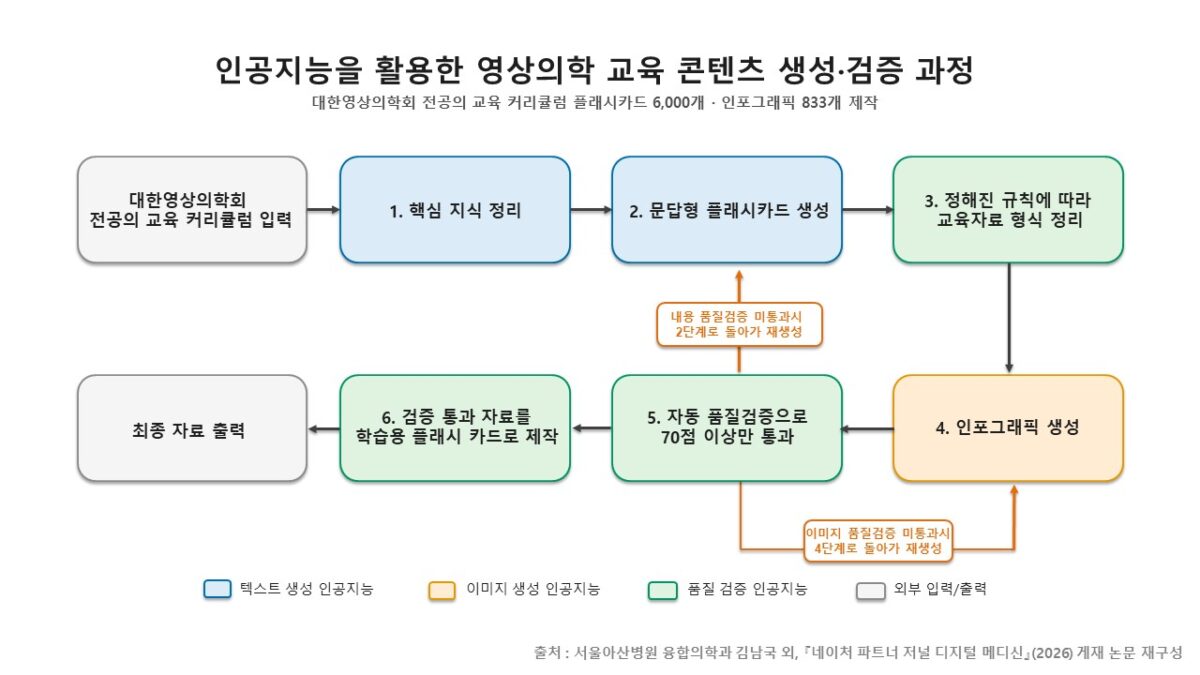
Nhóm nghiên cứu dựa trên chương trình đào tạo bác sĩ chuyên khoa của Hội Chẩn đoán hình ảnh Hàn Quốc, yêu cầu AI chọn lọc các nội dung cốt lõi cần cho kỳ thi để tạo tài liệu học.
Trước hết, họ tạo các thẻ flashcard gồm câu hỏi và câu trả lời. Flashcard là tài liệu học giúp ghi nhớ nội dung trọng tâm bằng cách lặp lại: một mặt là câu hỏi, mặt còn lại là đáp án.
Sau đó, họ chỉnh sửa nội dung và tạo infographic. AI tiếp tục kiểm tra chất lượng nội dung và hình ảnh; nếu không đạt tiêu chuẩn thì trả về bước trước để làm lại.
Qua quy trình này, họ tạo được 6.000 flashcard và 833 infographic thuộc 11 phân ngành của chẩn đoán hình ảnh.
Điều nhóm nghiên cứu muốn kiểm chứng không chỉ là AI có thể tạo ra bao nhiêu tài liệu. Câu hỏi quan trọng hơn là: các tài liệu mà AI tự kiểm tra và kết luận “không vấn đề” có thể được tin dùng đến mức nào trong đào tạo y khoa thực tế.
AI cho “đạt”, bác sĩ xem lại vẫn phát hiện 1% lỗi nghiêm trọng
Trong tổng số flashcard, 1.284 thẻ được con người thẩm định. 20 bác sĩ, gồm 9 bác sĩ nội trú chẩn đoán hình ảnh và 11 bác sĩ chuyên khoa, trực tiếp kiểm tra tính chính xác về mặt sự kiện, mức độ phù hợp làm tài liệu đào tạo chuyên khoa và xem có lỗi nào bắt buộc phải sửa hay không.
“Lỗi nghiêm trọng (blocking error)” trong nghiên cứu không phải lỗi chính tả hay thiết kế gượng gạo. Đây là lỗi sai về mặt sự kiện; nếu học theo nguyên trạng có thể dẫn bác sĩ đến nhận định lâm sàng sai lệch, nên bắt buộc phải sửa trước khi dùng cho đào tạo. Các trường hợp như đánh dấu sai vị trí giải phẫu, gán đặc điểm nhìn thấy trên hình ảnh cho một bệnh khác, hoặc đưa ra sai bệnh cần chẩn đoán phân biệt đều thuộc nhóm này. Thực tế, trong số tài liệu mà AI đánh giá là không có vấn đề, có trường hợp không chỉ ra đúng huyết khối tĩnh mạch xuất hiện cùng một khối ở thận.
Khi phân tích 1.100 lượt đánh giá của chuyên gia đối với 980 flashcard đã vượt qua kiểm tra tự động của AI, nhóm nghiên cứu ghi nhận 11 lượt có lỗi nghiêm trọng như vậy. Tính theo số lượt đánh giá, tương đương 1 lỗi trên mỗi 100 lượt.
Nói cách khác, AI kết luận “không có vấn đề lớn”, nhưng khi bác sĩ rà soát lại vẫn còn lỗi khiến khó có thể dùng nguyên trạng cho đào tạo.
Trước khi bắt đầu nghiên cứu, nhóm đặt tiêu chí khống chế tỷ lệ lỗi nghiêm trọng AI bỏ sót dưới 0,3%. Nghĩa là khi đánh giá 1.000 lượt, số trường hợp con người phát hiện lỗi nghiêm trọng trong tài liệu mà AI đã cho qua phải dưới 3 lượt.
Trong thống kê, việc thực tế có vấn đề nhưng kiểm tra lại kết luận không có vấn đề và bỏ sót được gọi là “âm tính giả (false negative)”. Trong nghiên cứu này, đó là trường hợp chuyên gia phát hiện muộn lỗi nghiêm trọng trong tài liệu mà AI đã cho qua.
Tuy nhiên, 0,3% không phải tiêu chuẩn an toàn chính thức do chính phủ hay hội chuyên ngành đặt ra cho AI trong đào tạo y khoa. Lĩnh vực này hiện chưa có ngưỡng sai số được công nhận, nên nhóm nghiên cứu tham khảo các tài liệu ở những lĩnh vực y tế khác liên quan đến an toàn người bệnh, như lỗi pha chế thuốc hoặc các trường hợp có bệnh nhưng bị bỏ sót khi kiểm tra, để đặt tiêu chí phục vụ nghiên cứu.
Vì vậy, không thể diễn giải mở rộng con số 1% lần này thành “tài liệu y khoa do AI tạo sinh tạo ra thì cứ 100 cái sẽ sai 1 cái”. Đây là kết quả đánh giá tài liệu đào tạo bác sĩ chuyên khoa chẩn đoán hình ảnh được tạo bởi một hệ thống AI cụ thể, theo phương pháp của nghiên cứu này.
Không chỉ là “ảo giác” của AI: vì sao không chặn được đáp án sai nhưng có vẻ đúng
Vậy vì sao AI vẫn bỏ sót lỗi dù đã tự kiểm tra lại tài liệu do chính mình tạo ra.
Hiện tượng AI tạo sinh tạo ra nội dung sai sự thật nhưng nghe có vẻ hợp lý thường được gọi là “ảo giác (hallucination)”. Tuy nhiên, nhóm nghiên cứu cho rằng khó có thể quy toàn bộ lỗi còn lại trong nghiên cứu này cho ảo giác của AI.
Nhóm nghiên cứu đã nhiều lần tinh chỉnh câu lệnh đưa cho AI để nâng độ chính xác của kiểm tra tự động. Ở bước thẩm định, họ yêu cầu AI tìm và tham khảo các tài liệu bằng chứng bên ngoài đã được chọn lọc. Dù vậy, trong 39 lỗi nghiêm trọng mà con người phát hiện, AI chỉ bắt được 28 lỗi. 11 lỗi còn lại vẫn lọt qua.
Một nguyên nhân chính được nêu là cách AI kiểm chứng lẫn nhau. Trong hệ thống này, kết quả do một AI tạo ra được AI ở bước tiếp theo nhận và kiểm tra, theo chuỗi tuần tự. Hệ thống không được thiết kế để nhiều AI phản biện lẫn nhau hoặc rà soát lại phán đoán trước đó. Vì thế, nếu ở bước trước tạo ra một đáp án sai nhưng có vẻ đúng, AI ở bước sau cũng có thể tiếp nhận mà không nghi ngờ.
Điểm đáng chú ý hơn là mức độ “chắc chắn” của AI. Với 11 lỗi bị bỏ sót mà chuyên gia phát hiện, AI kiểm tra tự động đều chấm điểm tối đa cho cả độ chính xác lẫn chất lượng đào tạo. Tức lỗi không nằm ở những tài liệu chỉ vừa đủ qua ngưỡng, mà xuất hiện ngay trong các tài liệu được AI đánh giá rất cao.
Đặc thù của lĩnh vực chẩn đoán hình ảnh cũng được cho là có tác động. Trong 11 lỗi AI bỏ sót, khoảng 3/4 là lỗi liên quan đến hình ảnh.
Dù phần mô tả bằng chữ đúng, nếu mũi tên chỉ nhầm cấu trúc giải phẫu hoặc quan hệ vị trí giữa cơ quan và mạch máu sai, thì tài liệu đào tạo chẩn đoán hình ảnh vẫn có vấn đề. Hiện AI có thể tạo ra hình ảnh y khoa trông khá thuyết phục, nhưng chưa đạt đến mức luôn tái hiện chính xác các quan hệ giải phẫu tinh vi.
Rốt cuộc, các lỗi được xác nhận trong nghiên cứu này khó giải thích bằng một nguyên nhân duy nhất. Có thể là sự kết hợp của không chỉ ảo giác của AI tạo ra nội dung sai, mà còn vấn đề AI khác lại tin vào đáp án sai nhưng có vẻ đúng, cách thẩm định tuần tự khiến khó rà soát lại phán đoán trước đó, và giới hạn trong việc thể hiện chính xác cấu trúc tinh vi của hình ảnh y khoa.
Những đáp án sai trông hợp lý với mắt người, thậm chí cũng “hợp lý” với kiểm tra của AI, lại càng dễ sống sót đến bước cuối.
AI là “con mắt thứ hai”, nhưng khâu xác nhận cuối vẫn phải do con người
Một kết quả đáng chú ý khác cũng xuất hiện. Nhân viên y tế trước hết đánh giá tài liệu mà không xem ý kiến của AI. Sau đó, họ kiểm tra xem AI đã chỉ ra điểm nào là vấn đề rồi đánh giá lại cùng tài liệu đó.
Khi đó, số lượt đánh giá chỉ ra lỗi nghiêm trọng tăng từ 39 lên 54. Điểm số chấm cho độ chính xác và chất lượng giáo dục của tài liệu cũng có xu hướng nghiêm khắc hơn ở lần đánh giá thứ hai.
Điều này cho thấy AI có thể được dùng như “con mắt thứ hai”, giúp con người kiểm tra lại những điểm có thể đã bỏ sót, thay vì thay thế chuyên gia.
Tuy vậy, không thể khẳng định nhờ ý kiến của AI mà năng lực phát hiện lỗi thực sự được cải thiện. Việc xem cùng một tài liệu hai lần có thể giúp phát hiện phần đã bỏ qua ở lần đầu. Cũng có khả năng chính việc biết AI đã chỉ ra vấn đề khiến người đánh giá trở nên khắt khe hơn.
Dù cần chuyên gia thẩm định cuối cùng, việc để con người kiểm tra toàn bộ tài liệu từ đầu đến cuối cũng không hề đơn giản.
Trong nghiên cứu này, thời gian trung vị để bác sĩ rà soát một flashcard là 53 giây. Với tốc độ đó, để xem hết 6.000 thẻ sẽ cần khoảng 88 giờ. Ngay cả khi rà soát 8 giờ mỗi ngày cũng mất khoảng 11 ngày.
Khâu xử lý tự động của AI cũng không hoàn hảo. Trong số flashcard được tạo ra, một phần gặp trục trặc trong quá trình xử lý nên không lưu lại được chính kết quả kiểm tra chất lượng tự động.
AI có lợi thế tạo ra khối lượng lớn tài liệu đào tạo trong thời gian ngắn. Nhưng nếu giao toàn bộ quy trình cho AI, lỗi vẫn có thể tồn tại. Ngược lại, nếu con người tự tạo và kiểm tra từng tài liệu, hiệu quả sử dụng AI sẽ giảm.
Vì vậy, mấu chốt là phân định ở đâu là phần có thể giao cho AI và ở đâu là phần con người bắt buộc phải kiểm tra.
Hướng đi nhóm nghiên cứu đề xuất là “human-in-the-loop”. Đây là cách để chuyên gia tham gia vào quá trình AI xử lý, kiểm tra các bước quan trọng và kết quả cuối. Theo đó, AI đảm nhiệm khâu tạo tài liệu và kiểm tra lần một; trước khi đưa vào đào tạo thực tế, chuyên gia đúng lĩnh vực sẽ lọc lỗi lần cuối.
Giáo sư Kim Nam-guk nói: “Chúng tôi đã chứng minh bằng một nghiên cứu quy mô lớn rằng để ứng dụng AI tạo sinh một cách an toàn trong môi trường giáo dục thực tế, việc thẩm định của chuyên gia là bắt buộc”, đồng thời nhấn mạnh “cần tiếp tục nghiên cứu để quản lý có hệ thống các lỗi mà thẩm định tự động bỏ sót và xây dựng tiêu chuẩn an toàn”.
Nghiên cứu viên Nam Yu-jin cho biết: “Nghiên cứu vừa xác nhận khả năng AI tạo sinh có thể sản xuất hàng loạt tài liệu đào tạo hình ảnh y khoa, vừa cho thấy thay vì dùng nguyên trạng tài liệu đã tạo ra, điều quan trọng là phân tích xem lỗi phát sinh ở bước nào và xây dựng quy trình sàng lọc”.