
La inteligencia artificial (IA) puede generar material de estudio para el examen de especialista y, después, la propia IA puede volver a revisarlo en busca de errores. Si el contenido supera ese filtro, ¿puede un residente que prepara el examen fiarse y estudiar tal cual?
En el caso del material para el examen de especialista en radiología, la respuesta se acerca más a un «todavía no». Incluso en contenidos que habían pasado la revisión automática de la IA se detectaron errores graves en torno al 1%, capaces de enturbiar el juicio clínico de un médico.
El Hospital Asan de Seoul informó el día 24 de los resultados de un estudio en el que, tras desarrollar un sistema para producir en masa materiales docentes de radiología con IA generativa y filtrar automáticamente los errores, pidió a médicos que los verificaran de nuevo.
La investigación la realizaron el profesor Kim Nam-kuk y la investigadora Nam Yu-jin, del Departamento de Medicina Convergente del Hospital Asan de Seoul, junto con el profesor Hong Pa, del Departamento de Radiología del Hospital Samsung Changwon. El artículo se publicó en el último número de la revista internacional 〈npj Digital Medicine〉.
Crean 6.000 tarjetas de estudio dentro del temario del examen de especialista
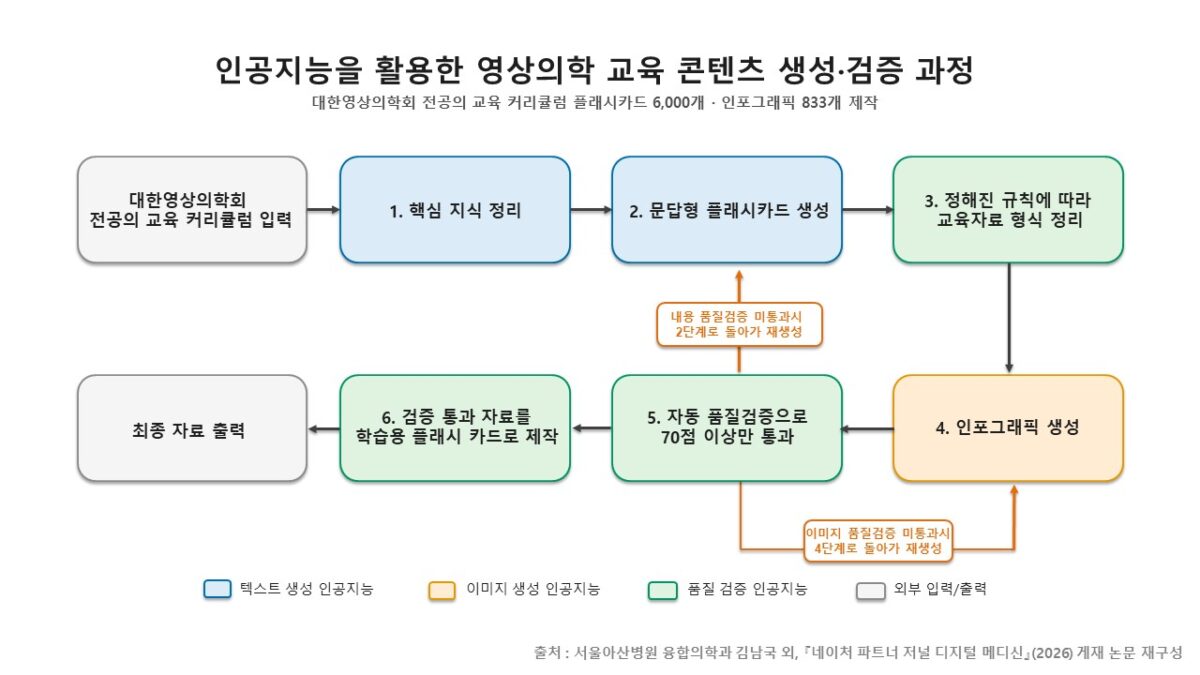
El equipo investigador, basándose en el programa formativo de especialista de la Sociedad Coreana de Radiología, hizo que la IA seleccionara los contenidos clave necesarios para el examen y elaborara materiales de aprendizaje.
En primer lugar, produjeron tarjetas tipo «flashcard» compuestas por preguntas y respuestas. Las flashcards son un material de estudio que permite aprender de forma repetitiva los puntos esenciales: en una cara se coloca la pregunta y en la otra, la respuesta.
Después, pulieron el contenido y crearon infografías. La IA volvió a comprobar la calidad del texto y de las imágenes y, si no cumplían los criterios, las devolvía a la fase anterior para rehacerlas.
Tras este proceso, se generaron 6.000 flashcards y 833 infografías en 11 subespecialidades de radiología.
Lo que el equipo quería comprobar no se limitaba a cuánta cantidad de material podía producir la IA. La pregunta más importante era hasta qué punto podía confiarse, para la docencia médica real, en contenidos que la propia IA había revisado y declarado «sin problemas».
La IA dio el «aprobado»… pero los médicos hallaron un 1% de errores graves
De todas las flashcards, 1.284 se sometieron a verificación humana. Un total de 20 médicos —9 residentes de radiología y 11 especialistas— revisaron directamente si los hechos eran correctos, si el material era adecuado para la formación de especialistas y si contenía errores que debían corregirse obligatoriamente.
El «error grave (blocking error)» al que se refiere el estudio no significa una simple errata o un diseño poco natural. Es un error factual que, si se aprende tal cual, puede conducir el juicio clínico del médico en una dirección equivocada y que debe corregirse necesariamente antes de usarlo en la enseñanza. Entran aquí casos como señalar mal una localización anatómica, vincular rasgos visibles en una imagen con una enfermedad equivocada o presentar de forma incorrecta enfermedades que deben diferenciarse en el diagnóstico. De hecho, entre los materiales que la IA consideró sin problemas hubo un caso en el que no se identificó correctamente una trombosis venosa asociada a una masa en el riñón.
Al analizar 1.100 evaluaciones emitidas por expertos sobre 980 flashcards que habían superado la revisión automática de la IA, se detectaron 11 casos de este tipo de error grave. Si se toma como base el número de evaluaciones, equivale a 1 caso por cada 100.
Es decir, la IA concluyó que «no había grandes problemas», pero al revisarlo de nuevo, los médicos encontraron errores que impedían usar el material tal cual en la docencia.
Antes de iniciar el estudio, el equipo fijó como criterio mantener por debajo del 0,3% los errores graves que la IA no detectara. Esto significa que, al evaluar 1.000 casos, deberían ser menos de 3 los casos en los que una persona encontrara un error grave en material que la IA había dejado pasar como correcto.
En estadística, cuando existe un problema real pero la prueba lo considera inexistente y lo pasa por alto, se denomina «falso negativo (false negative)». En este estudio, corresponde a los casos en los que los expertos detectaron más tarde errores graves en material que la IA había aprobado.
Ahora bien, el 0,3% no es un criterio oficial de seguridad para IA en educación médica fijado por el Gobierno o por sociedades científicas. Como en este ámbito aún no existe un umbral de error permitido reconocido, el equipo estableció un criterio de investigación tomando como referencia materiales de otros campos médicos relacionados con la seguridad del paciente, como errores de dispensación de fármacos o casos en los que una prueba pasa por alto una enfermedad existente.
Por tanto, no puede extrapolarse el 1% obtenido aquí para afirmar que «el material médico creado por IA generativa se equivoca en 1 de cada 100». ’ Se trata del resultado de evaluar, con el método de este estudio, material docente para especialistas en radiología elaborado con un sistema concreto de IA.
No es solo un problema de «alucinaciones» de la IA… por qué no filtró respuestas erróneas verosímiles
Entonces, ¿por qué la IA pasó por alto errores pese a revisar de nuevo el material que ella misma había creado?
Se suele llamar «alucinación (hallucination)» al fenómeno por el que la IA generativa produce contenidos falsos con apariencia verosímil. Sin embargo, en este estudio resulta difícil atribuir todos los errores restantes únicamente a las alucinaciones de la IA.
Para mejorar la precisión de la revisión automática, el equipo ajustó en varias ocasiones las instrucciones dadas a la IA. En la fase de verificación, hizo que buscara y consultara fuentes externas seleccionadas. Aun así, de los 39 errores graves detectados por personas, la IA solo captó 28. Los 11 restantes pasaron el filtro.
Entre las principales causas se señala el método de verificación entre IAs. En este sistema, el resultado generado por una IA pasaba a la IA de la fase siguiente para su revisión, en una secuencia de trabajo encadenada. No era una estructura en la que varias IAs se refutaran entre sí o reexaminaran decisiones previas. En consecuencia, si en una fase anterior se generaba una respuesta errónea pero plausible, la IA de la fase posterior podía aceptarla sin sospechar.
Más llamativa aún fue la «confianza» de la IA. En los 11 errores omitidos que detectaron los expertos, la IA de revisión automática otorgó la máxima puntuación tanto en precisión como en calidad educativa. No se trataba de material que apenas superara el corte: los errores aparecieron en contenidos que la IA había valorado muy positivamente como libres de problemas.
También parece haber influido la naturaleza de la radiología. De los 11 errores que la IA no detectó, aproximadamente tres cuartas partes estaban relacionados con imágenes.
Aunque la explicación escrita sea correcta, si una flecha señala una estructura anatómica equivocada o si la relación espacial entre órganos y vasos sanguíneos es errónea, el material resulta problemático para la enseñanza de radiología. Hoy la IA puede generar imágenes médicas que, a primera vista, parecen plausibles, pero aún no ha alcanzado un nivel en el que reproduzca siempre con precisión relaciones anatómicas finas.
En definitiva, los errores confirmados en este estudio no se explican por una sola causa. Es posible que hayan actuado conjuntamente no solo las alucinaciones de la IA que generan contenido incorrecto, sino también el problema de que otra IA crea de nuevo una respuesta errónea pero verosímil, un método de verificación secuencial que dificulta reexaminar decisiones previas y las limitaciones para representar con precisión estructuras detalladas en imágenes médicas.
En otras palabras, las respuestas erróneas que parecían plausibles tanto a ojos humanos como para la revisión de la IA fueron, precisamente, las que más fácilmente sobrevivieron hasta el final.
La IA como «segundo par de ojos»… pero la última comprobación sigue siendo humana
También apareció un resultado interesante. El personal médico evaluó primero el material sin ver la opinión de la IA. Después, comprobó qué partes había señalado la IA como problemáticas y volvió a revisar el mismo material.
Así, el número de evaluaciones que señalaban errores graves aumentó de 39 a 54. Las puntuaciones otorgadas a la precisión del material y a su calidad educativa también tendieron a ser más estrictas en la segunda evaluación.
Es un indicio de que la IA podría utilizarse no tanto para sustituir a los expertos como para actuar como un «segundo par de ojos» que empuja a revisar de nuevo aspectos que una persona podría haber pasado por alto.
Con todo, no puede afirmarse de forma concluyente que, gracias a la opinión de la IA, la capacidad de detectar errores mejorara realmente. Al revisar el mismo material dos veces, es posible que se encontraran aspectos que se habían escapado en la primera lectura. También cabe que el mero hecho de saber que la IA había señalado un problema hiciera al evaluador más exigente.
Que sea necesaria la revisión final de un experto tampoco significa que sea sencillo que una persona compruebe todo el material de principio a fin.
En este estudio, el tiempo mediano que tardó un médico en revisar una flashcard fue de 53 segundos. A ese ritmo, revisar las 6.000 requeriría unas 88 horas. Incluso dedicando 8 horas al día, llevaría alrededor de 11 días.
El procesamiento automático de la IA tampoco fue perfecto. En parte de las flashcards generadas surgieron problemas durante el proceso y ni siquiera quedó registrado el resultado de la inspección automática de calidad.
La IA tiene la ventaja de crear en poco tiempo una enorme cantidad de material educativo. Pero si se le confía todo el proceso, pueden quedar errores. Por el contrario, si una persona crea y revisa uno por uno los materiales, se reduce la eficiencia de usar IA.
En última instancia, la clave es dónde trazar la línea entre lo que se delega en la IA y lo que una persona debe comprobar obligatoriamente.
La orientación que propone el equipo es el «human-in-the-loop». Es un enfoque en el que los expertos participan en el proceso de trabajo de la IA para verificar etapas importantes y el resultado final. Por ejemplo, la IA se encarga de la elaboración del material y de una primera revisión, y antes de usarlo en la docencia real un especialista del área filtra por última vez los errores.
El profesor Kim Nam-kuk afirmó: «Hemos demostrado, mediante un estudio a gran escala, que para utilizar de forma segura la IA generativa en entornos educativos reales es imprescindible la verificación por expertos», y añadió: «Es necesario continuar investigando para gestionar de forma sistemática los errores que la verificación automática pasa por alto y para establecer criterios de seguridad».
La investigadora Nam Yu-jin dijo: «Al mismo tiempo que confirmamos la posibilidad de que la IA generativa produzca en masa material educativo de imagen médica, mostramos que es importante no usar sin más el material creado, sino analizar en qué fase se producen qué errores y filtrarlos».