
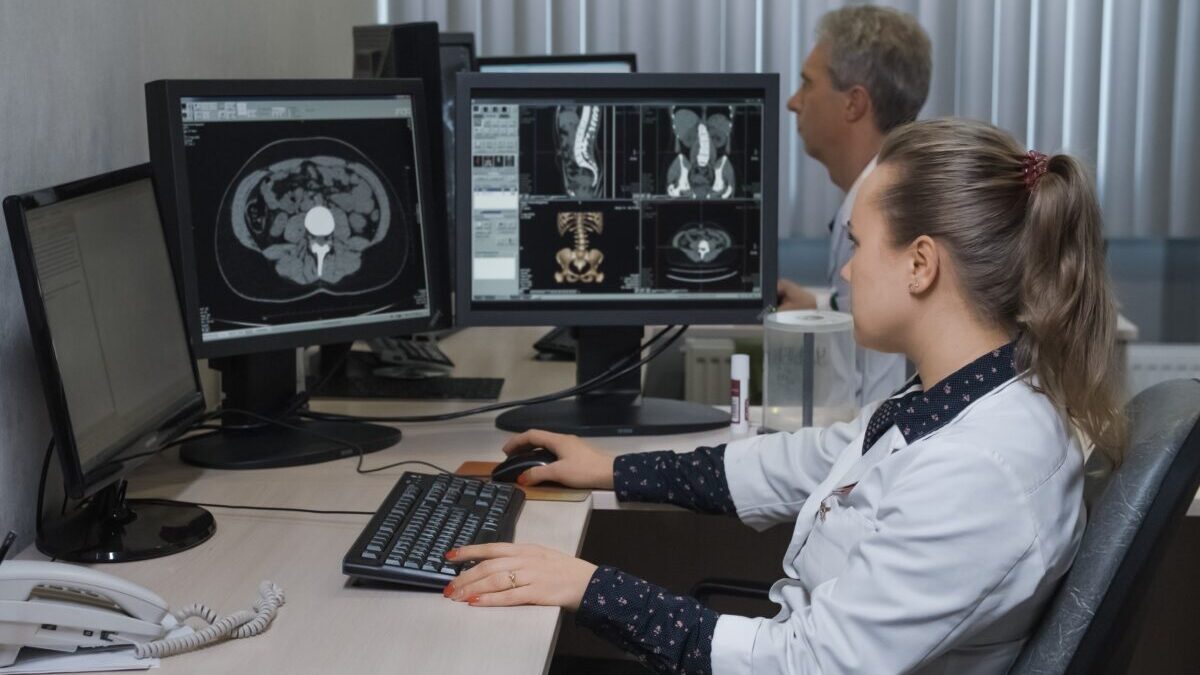
بات الذكاء الاصطناعي (AI) قادراً على توليد مواد تعليمية لاختبار الأطباء الاختصاصيين، ثم يتولى الذكاء الاصطناعي نفسه مهمة فحصها بحثاً عن الأخطاء. لكن يبقى السؤال: هل يمكن للطبيب المقيم الذي يستعد لاختبار الاختصاص أن يعتمد هذه المواد ويدرس منها كما هي لمجرد أنها اجتازت مرحلة المراجعة الآلية؟
في مواد اختبار اختصاص الأشعة، جاءت الإجابة أقرب إلى «ليس بعد». إذ رُصدت أخطاء جسيمة بنحو 1% حتى في المواد التي اجتازت الفحص الآلي بالذكاء الاصطناعي، وهي أخطاء قد تربك الحكم السريري للطبيب.
وفي 24 من الشهر الجاري، أعلن مستشفى أسان في سيول نتائج دراسة طوّر فيها نظاماً لإنتاج مواد تعليم الأشعة بكميات كبيرة باستخدام الذكاء الاصطناعي التوليدي مع آلية لفرز الأخطاء تلقائياً، قبل إخضاع المواد للتحقق مجدداً على يد أطباء.
وأجرى الدراسة كل من البروفيسور كيم نام-غوك والباحث نام يو-جين من قسم الطب التكاملي في مستشفى أسان في سيول، والبروفيسور هونغ با من قسم الأشعة في مستشفى سامسونغ تشانغوون. ونُشرت الورقة في العدد الأخير من الدورية الدولية 《npj Digital Medicine》.
إنتاج 6000 بطاقة تعليمية ضمن نطاق اختبار الاختصاص
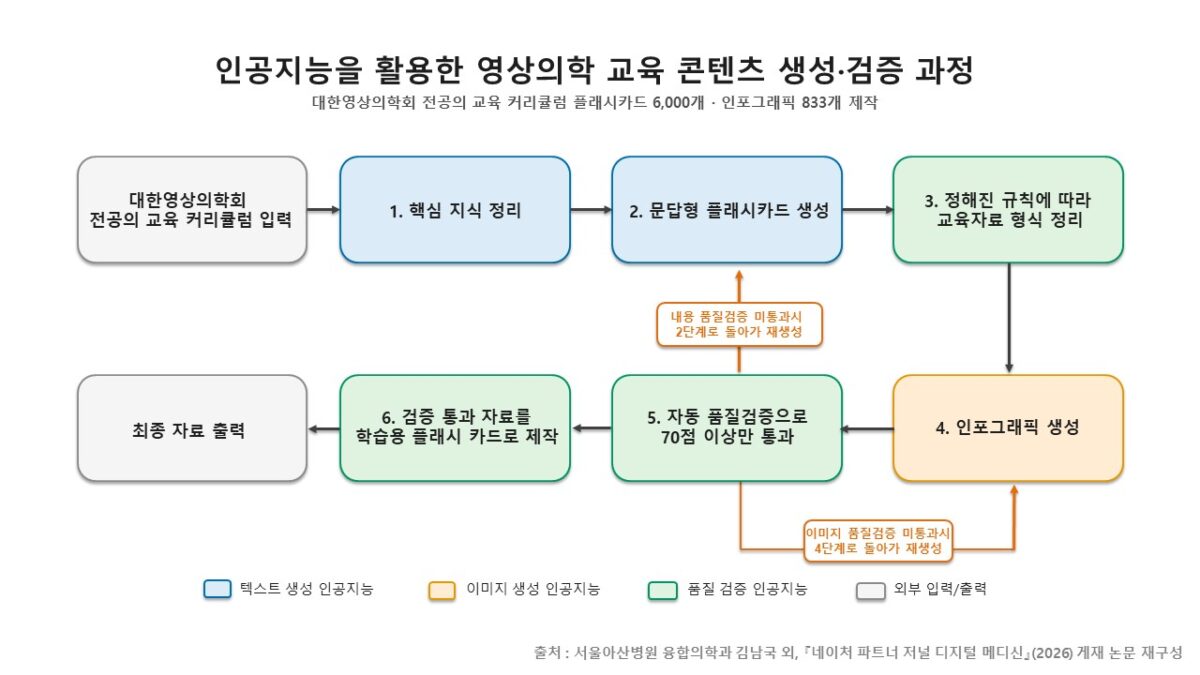
اعتمد فريق البحث على المنهج التعليمي لاختصاصيي الجمعية الكورية للأشعة، وطلب من الذكاء الاصطناعي انتقاء النقاط الجوهرية اللازمة للاختبار وإعداد مواد تعليمية.
وبدأ الفريق بإنتاج بطاقات تعليمية (فلاش كارد) تتكون من سؤال وجواب. والبطاقة التعليمية مادة تدريبية تُكتب فيها الأسئلة على جانب والإجابات على الجانب الآخر لتكرار تعلّم النقاط الأساسية.
ثم نُقّحت المحتويات وصُنعت رسوم معلوماتية (إنفوغرافيك). وبعد ذلك أعاد الذكاء الاصطناعي فحص جودة المحتوى والصور، وإذا لم تستوفِ المعايير أُعيدت إلى المرحلة السابقة لإنتاجها من جديد.
ومن خلال هذه العملية، أُنتجت 6000 بطاقة تعليمية و833 رسماً معلوماتياً عبر 11 تخصصاً فرعياً في الأشعة.
ولم يقتصر هدف الباحثين على قياس حجم ما يستطيع الذكاء الاصطناعي إنتاجه من مواد. بل ركّزوا على سؤال أكثر حساسية: إلى أي حد يمكن الوثوق بالمواد التي راجعها الذكاء الاصطناعي بنفسه واعتبرها «خالية من المشكلات» عند استخدامها فعلياً في التعليم الطبي؟
الذكاء الاصطناعي منحها «قبولاً»… لكن الأطباء رصدوا أخطاء جسيمة بنسبة 1%
ومن بين إجمالي البطاقات التعليمية، خضعت 1284 بطاقة للتحقق البشري. وراجع 20 طبيباً—منهم 9 أطباء مقيمين في الأشعة و11 اختصاصياً—مدى صحة الوقائع، وملاءمتها كمواد تعليمية لاختصاصيي الأشعة، وما إذا كانت تتضمن أخطاء يجب تصحيحها حتماً.
ولا تعني «الأخطاء الجسيمة (blocking error)» في هذه الدراسة مجرد أخطاء مطبعية أو تصميم غير مريح. بل هي أخطاء واقعية يجب تصحيحها قبل استخدامها في التعليم لأنها قد تقود الحكم السريري للطبيب إلى اتجاه خاطئ إذا تم تعلمها كما هي. ومن أمثلتها: الإشارة إلى موضع تشريحي بشكل خاطئ، أو ربط سمة ظاهرة في الصورة بمرض غير ذي صلة، أو طرح تشخيص تفريقي على نحو غير صحيح. وفعلياً، تضمنت بعض المواد التي اعتبرها الذكاء الاصطناعي بلا مشكلة حالة لم تُحدَّد فيها بشكل صحيح خثرة وريدية ظهرت مع كتلة في الكلية.
وعند تحليل 1100 تقييم خبير لعدد 980 بطاقة تعليمية اجتازت الفحص الآلي للذكاء الاصطناعي، كُشف عن 11 حالة من هذه الأخطاء الجسيمة. وباحتساب عدد التقييمات، يعادل ذلك حالة واحدة لكل 100 تقييم.
أي أن الذكاء الاصطناعي خلص إلى أنه «لا توجد مشكلة كبيرة»، لكن مراجعة الأطباء أظهرت بقاء أخطاء تجعل استخدام المواد في التعليم كما هي أمراً صعباً.
وقبل بدء الدراسة، وضع الباحثون معياراً يقضي بكبح الأخطاء الجسيمة التي يفوتها الذكاء الاصطناعي إلى أقل من 0.3%. أي أنه عند تقييم 1000 حالة، ينبغي أن تكون الحالات التي يعثر فيها البشر على أخطاء جسيمة ضمن مواد مرّرها الذكاء الاصطناعي باعتبارها سليمة أقل من 3 حالات.
وفي الإحصاء، يُطلق على وجود مشكلة فعلية لكن الفحص يحكم بعدم وجود مشكلة ويفوتها اسم «السلبية الكاذبة (false negative)». وفي هذه الدراسة، ينطبق ذلك على الحالات التي مرّرها الذكاء الاصطناعي ثم اكتشف الخبراء لاحقاً فيها أخطاء جسيمة.
غير أن نسبة 0.3% ليست معيار سلامة رسمياً للذكاء الاصطناعي في التعليم الطبي تحدده الحكومة أو الجمعيات العلمية. إذ لا توجد حتى الآن معايير معتمدة لمستوى الأخطاء المسموح به في هذا المجال، لذلك استند الباحثون إلى مواد من مجالات طبية أخرى مرتبطة بسلامة المرضى—مثل أخطاء صرف الأدوية أو حالات وجود مرض لكن الفحص يفوته—لوضع معيار بحثي.
وبناءً عليه، لا يمكن توسيع تفسير نسبة 1% الصادرة هنا إلى القول إن «المواد الطبية التي يصنعها الذكاء الاصطناعي التوليدي تكون خاطئة في واحدة من كل 100 مادة». فهذه نتيجة تقييم مواد تعليمية لاختصاص الأشعة أُنتجت بنظام ذكاء اصطناعي محدد وبمنهجية التقييم المستخدمة في هذه الدراسة.
ليست مشكلة «هلوسة» الذكاء الاصطناعي وحدها… لماذا لم يلتقط إجابات خاطئة تبدو مقنعة؟
فلماذا أفلتت هذه الأخطاء من الذكاء الاصطناعي رغم أنه أعاد فحص المواد التي أنشأها؟
ويُطلق عادة على ظاهرة قيام الذكاء الاصطناعي التوليدي بصياغة محتوى غير مطابق للواقع بشكل يبدو مقنعاً اسم «الهلوسة (hallucination)». لكن من الصعب عزو جميع الأخطاء المتبقية في هذه الدراسة إلى هلوسة الذكاء الاصطناعي وحدها.
وقام الباحثون بتنقيح التعليمات المقدمة للذكاء الاصطناعي مرات عدة لرفع دقة الفحص الآلي. وفي مرحلة التحقق، جعلوه يبحث عن مراجع خارجية منتقاة ويستند إليها. ومع ذلك، من بين 39 خطأً جسيماً اكتشفها البشر، التقط الذكاء الاصطناعي 28 خطأً فقط، بينما مرّت الأخطاء الـ11 المتبقية كما هي.
وأشار الباحثون إلى أن أحد الأسباب الرئيسية يعود إلى أسلوب التحقق بين نماذج الذكاء الاصطناعي نفسها. ففي هذا النظام، كان ذكاء اصطناعي ينشئ المخرجات ثم يتسلمها ذكاء اصطناعي في المرحلة التالية ليفحصها، في تسلسل متتابع. ولم تكن هناك بنية تسمح لعدة نماذج ذكاء اصطناعي بتبادل الاعتراضات أو إعادة تدقيق الأحكام السابقة. ما يعني أنه إذا صيغت إجابة خاطئة تبدو مقنعة في مرحلة مبكرة، فقد يقبلها الذكاء الاصطناعي في المرحلة التالية دون تشكيك.
واللافت أكثر كان «يقين» الذكاء الاصطناعي. ففي الأخطاء الـ11 التي فاتت، منح ذكاء اصطناعي الفحص الآلي أعلى الدرجات لكل من الدقة وجودة التعليم. أي أن الأخطاء لم تظهر في مواد بالكاد تجاوزت حد القبول، بل في مواد قيّمها الذكاء الاصطناعي بدرجة عالية على أنها بلا مشكلة.
كما بدا أن طبيعة مجال الأشعة لعبت دوراً أيضاً. إذ إن نحو ثلاثة أرباع الأخطاء الـ11 التي فاتت على الذكاء الاصطناعي كانت أخطاء مرتبطة بالصور.
حتى لو كان الشرح النصي صحيحاً، فإن توجيه السهم إلى بنية تشريحية غير صحيحة أو خطأ علاقة الموضع بين الأعضاء والأوعية الدموية يجعل المادة التعليمية في الأشعة إشكالية. وفي الوقت الراهن، يستطيع الذكاء الاصطناعي إنتاج صور طبية تبدو مقنعة للوهلة الأولى، لكنه لم يصل بعد إلى مرحلة تجسيد العلاقات التشريحية الدقيقة بدقة ثابتة.
وفي المحصلة، يصعب ردّ الأخطاء التي كُشفت في هذه الدراسة إلى سبب واحد. فمن المحتمل أن تكون هلوسة الذكاء الاصطناعي التي تنتج محتوى خاطئاً، ومشكلة أن ذكاءً اصطناعياً آخر يصدق إجابات خاطئة تبدو مقنعة، وطريقة التحقق التسلسلية التي تجعل إعادة فحص الأحكام السابقة أمراً صعباً، وحدود القدرة على التعبير الدقيق عن البنى التفصيلية في الصور الطبية قد تفاعلت معاً.
وبذلك، كانت الإجابات الخاطئة التي تبدو مقنعة للعين البشرية—ولفحص الذكاء الاصطناعي أيضاً—أكثر قابلية للبقاء حتى النهاية.
الذكاء الاصطناعي «عين ثانية»… لكن التحقق الأخير يبقى للبشر
وسجلت الدراسة نتائج أخرى لافتة. فقد قيّم الطاقم الطبي المواد أولاً دون الاطلاع على رأي الذكاء الاصطناعي. ثم راجعوا ما الذي حدده الذكاء الاصطناعي باعتباره مشكلة، وبعد ذلك أعادوا فحص المواد نفسها مرة أخرى.
وعندها ارتفع عدد التقييمات التي أشارت إلى أخطاء جسيمة من 39 إلى 54. كما أظهرت الدرجات الممنوحة لدقة المواد وجودتها التعليمية ميلاً إلى أن تصبح أكثر صرامة في التقييم الثاني.
ويعزز ذلك فكرة استخدام الذكاء الاصطناعي بوصفه «عيناً ثانية» تدفع البشر إلى إعادة التحقق من نقاط ربما فاتتهم، بدلاً من أن يحل محل الخبراء.
ومع ذلك، لا يمكن الجزم بأن القدرة على اكتشاف الأخطاء تحسنت فعلياً بفضل رأي الذكاء الاصطناعي. فقد يكون المقيمون اكتشفوا ما فاتهم في المرة الأولى لمجرد أنهم فحصوا المواد مرتين. كما قد يكون مجرد العلم بأن الذكاء الاصطناعي أشار إلى مشكلة قد جعل المقيم أكثر تدقيقاً.
كما أن الحاجة إلى تدقيق نهائي من الخبراء لا تعني أن مراجعة جميع المواد من البداية إلى النهاية بواسطة البشر أمر سهل.
في هذه الدراسة، كان الزمن الوسيط الذي استغرقه الطبيب لمراجعة بطاقة تعليمية واحدة 53 ثانية. وبذلك، فإن مراجعة جميع البطاقات الـ6000 بهذه الوتيرة تتطلب نحو 88 ساعة. وحتى مع مراجعة 8 ساعات يومياً، يستغرق الأمر قرابة 11 يوماً.
ولم تكن المعالجة الآلية للذكاء الاصطناعي كاملة أيضاً. إذ إن بعض البطاقات التعليمية المُولَّدة واجهت مشكلات أثناء المعالجة، فلم تُسجَّل لها نتائج فحص الجودة الآلي من الأساس.
يمتلك الذكاء الاصطناعي ميزة إنتاج كم هائل من المواد التعليمية في وقت قصير. لكن إسناد العملية بأكملها إليه قد يترك أخطاء. وعلى العكس، إذا أنشأ البشر المواد وفحصوها واحدة تلو الأخرى، تتراجع كفاءة استخدام الذكاء الاصطناعي.
وفي النهاية، يبقى العامل الحاسم هو أين نرسم الحد بين ما يمكن إسناده إلى الذكاء الاصطناعي وما يجب أن يتحقق منه البشر حتماً.
والاتجاه الذي طرحه الباحثون هو «الإنسان ضمن الحلقة (Human-in-the-loop)». وهو أسلوب يشارك فيه الخبراء أثناء معالجة الذكاء الاصطناعي للعمل للتحقق من المراحل المهمة والنتائج النهائية. أي أن يتولى الذكاء الاصطناعي إنتاج المواد والفحص الأولي، بينما يقوم خبير في المجال المعني بفرز الأخطاء للمرة الأخيرة قبل استخدامها فعلياً في التعليم.
وقال البروفيسور كيم نام-غوك: «أثبتنا عبر دراسة واسعة النطاق أن التحقق من الخبراء ضروري لاستخدام الذكاء الاصطناعي التوليدي بأمان في بيئات التعليم الفعلية»، مضيفاً: «هناك حاجة لمواصلة الأبحاث لإدارة الأخطاء التي يفوتها التحقق الآلي بشكل منهجي ووضع معايير للسلامة».
وقال الباحث نام يو-جين: «أكدنا إمكانية أن ينتج الذكاء الاصطناعي التوليدي مواد تعليمية للتصوير الطبي بكميات كبيرة، وفي الوقت نفسه تُظهر النتائج أن من المهم عدم استخدام المواد المُنتَجة كما هي، بل تحليل أين وفي أي مرحلة تنشأ الأخطاء وكيفية فرزها».