
人工知能(AI)が専門医試験向けの学習資料を作成し、別のAIが誤りを自動で検査する。ここまで通過した資料であれば、専門医試験を準備する研修医がそのまま信頼して学んでもよいのか。
放射線科の専門医試験向け資料を対象にした検証では、答えは「現時点では難しい」に近い内容でした。AIの自動検査を通過した資料でも、医師の臨床判断を誤らせかねない重大な誤りが約1%見つかったためです。
ソウル峨山病院は24日、生成AIで放射線科の教育資料を大量に作成し、誤りを自動でふるい落とす仕組みを開発したうえで、医師が再検証した研究結果を公表しました。
研究は、ソウル峨山病院の融合医学科キム・ナムグク教授、ナム・ユジン研究員と、サムスン昌原病院の放射線科ホン・パ教授が実施しました。論文は国際学術誌〈npj デジタル医学(npj Digital Medicine)〉の最新号に掲載されました。
専門医試験範囲でフラッシュカード6000枚を作成
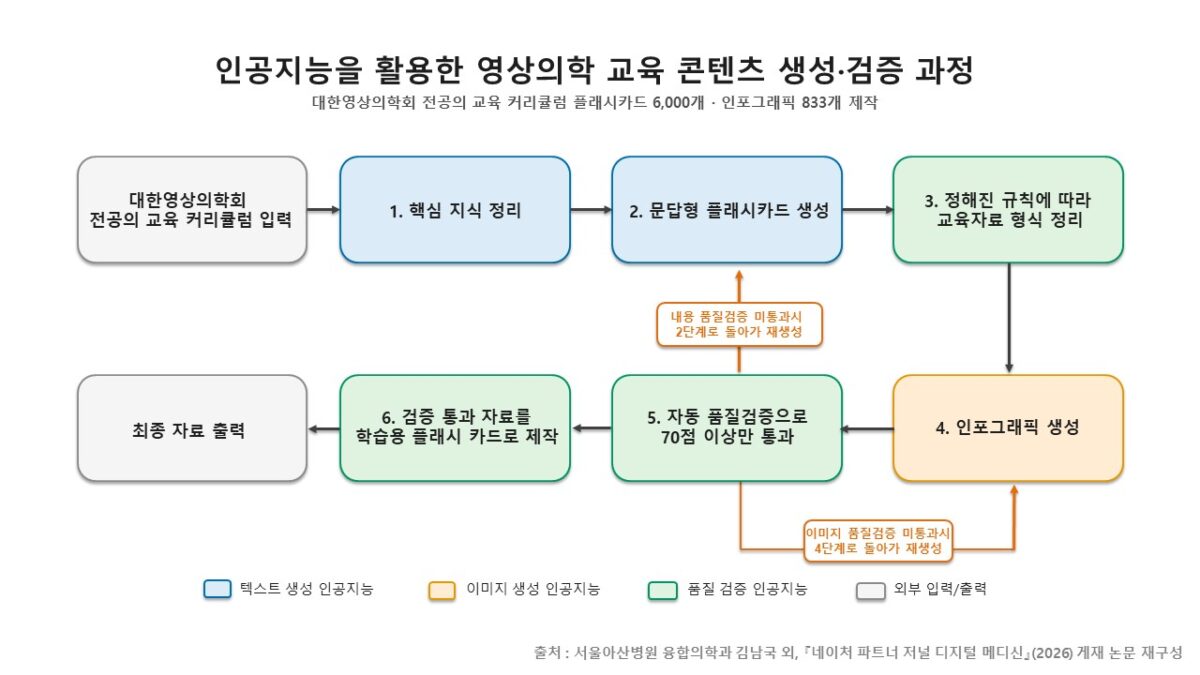
研究チームは、大韓放射線医学会の専門医教育課程を基に、AIに試験に必要な中核内容を抽出させ、学習資料を作成させました。
まず、質問と回答で構成するフラッシュカードを作成しました。フラッシュカードは片面に質問、もう片面に答えを載せ、要点を繰り返し学ぶ学習資料です。
続いて内容を整え、インフォグラフィックを作成しました。AIが再び内容と画像の品質を検査し、基準を満たさない場合は前段階に戻して作り直すようにしました。
この過程を経て、放射線科の11の細部分野でフラッシュカード6000枚とインフォグラフィック833枚が作成されました。
研究チームが焦点を当てたのは、AIがどれほど多くの資料を作れるかだけではありません。AIが自ら検査して「問題なし」と判定した資料を、実際の医学教育でどこまで信頼して使えるのかが、より重要な論点でした。
AIが「合格」を出したのに…医師が見ると重大エラー1%
全フラッシュカードのうち1284枚は、人による検証を受けました。放射線科研修医9人と専門医11人の計20人が、事実関係が正しいか、専門医教育資料として適切か、必ず修正すべき誤りがあるかを直接確認しました。
研究でいう「重大エラー(blocking error)」は、単なる誤字脱字や不自然なデザインを指すものではありません。そのまま学ぶと医師の臨床判断を誤った方向へ導きかねず、教育に使う前に必ず修正すべき事実誤認です。 解剖学的位置を誤って表示したり、画像で見える特徴を見当違いの疾患と結び付けたり、鑑別すべき疾患を誤って提示したりするケースなどが該当します。実際に、AIが問題なしと判定した資料の中には、腎臓にできた腫瘤とともに現れた静脈血栓を適切に指摘できていない例もありました。
AIの自動検査を通過したフラッシュカード980枚について、専門家が下した評価1100件を分析したところ、11件でこうした重大エラーが見つかりました。評価件数を基準にすると、100件当たり1件の割合です。
AIは「大きな問題はない」と判断したものの、医師が改めて確認すると、そのまま教育に使いにくい誤りが残っていたことになります。
研究チームは研究開始前、AIが見落とす重大エラーを0.3%未満に抑えるという基準を定めました。1000件を評価した際、AIが問題なしとして通過させた資料から、人が重大エラーを見つけるケースが3件未満であるべき、という意味です。
統計では、実際には問題があるのに検査で問題なしと判断して見落とすことを「偽陰性(false negative)」と呼びます。今回の研究では、AIが通過させた資料から専門家が後になって重大エラーを見つけたケースがこれに当たります。
ただし0.3%は、政府や学会が定めた医学教育AIの公式な安全基準ではありません。この分野には公認の誤り許容基準がまだなく、研究チームが調剤ミスや、疾患があるのに検査で見落とす事例など、患者安全に関わる他の医療分野の資料を参考にして研究用の基準として設定しました。
したがって、今回の1%を「生成AIが作った医療資料は100個のうち1個が間違っている」と拡大解釈することはできません。特定のAIシステムで作成した放射線科専門医向け教育資料を、今回の研究手法で評価した結果です。
AIの「幻覚」だけが原因ではない…もっともらしい誤答をなぜ弾けなかったのか
では、AIはなぜ、自ら作成した資料を再検査しても誤りを見落としたのでしょうか。
生成AIが事実と異なる内容をもっともらしく作り出す現象は、一般に「幻覚(hallucination)」と呼ばれます。ただ、今回残った誤りをすべてAIの幻覚だけで説明するのは難しいといいます。
研究チームは自動検査の精度を高めるため、AIに与える指示文を何度も調整しました。検証段階では、外部の選別された根拠資料を探して参照するようにしました。それでも、人が見つけた重大エラー39件のうち、AIが捕捉したのは28件でした。残る11件はそのまま通過しました。
主な要因として、AI同士で検証する方式が挙げられます。今回の仕組みでは、あるAIが作った結果を次段階のAIが受け取り検査する形で、作業が順番に進みました。複数のAIが互いに反論したり、先の判断を改めて吟味したりする構造ではありませんでした。前段階でもっともらしい誤答が作られると、後段階のAIも疑わず受け入れてしまい得る、ということです。
さらに目立ったのは、AIの「確信」でした。専門家が見つけた11件の見落としエラーについて、自動検査AIは正確性と教育品質の双方で最高点を付けていました。合格ラインをかろうじて超えた資料ではなく、AIが問題なしと高く評価した資料から誤りが出たのです。
放射線科という分野の特性も影響した可能性があります。AIが見落とした11件のうち約4分の3は、画像に関する誤りでした。
文章の説明が正しくても、矢印が見当違いの解剖学的構造を指していたり、臓器と血管の位置関係が誤っていたりすれば、放射線科の教育資料としては問題になります。現在のAIは一見もっともらしい医療画像を作れますが、精緻な解剖学的関係まで常に正確に再現できる段階には至っていません。
結局、今回確認された誤りは単一の原因では説明しにくいといえます。誤った内容を作り出すAIの幻覚だけでなく、もっともらしい誤答を別のAIが再び信じてしまう問題、先の判断を振り返りにくい逐次的な検証方式、医療画像の精密な構造を正確に表現するうえでの限界が複合的に作用した可能性があります。
人の目にもAIの検査にももっともらしく見える誤答ほど、かえって最後まで残りやすかった、ということです。
AIは「第二の目」…それでも最終確認は人が担う
興味深い結果も示されました。医療者はまずAIの見解を見ずに資料を評価しました。その後、AIがどの部分を問題として指摘したかを確認し、同じ資料を改めて見直しました。
すると、重大エラーを指摘した評価件数は39件から54件に増えました。資料の正確性と教育的品質に付けた点数も、2回目の評価でより厳しくなる傾向を示しました。
AIが専門家の代わりになるというより、人が見落としたかもしれない点を改めて確認させる「第二の目」として活用できる可能性を示す結果です。
ただ、AIの見解によって誤り発見能力が実際に向上したと断定はできません。同じ資料を2回確認する中で、最初に見落とした点を見つけた可能性もあります。AIが問題を指摘したという事実そのものが、評価者をより厳格にした可能性もあります。
専門家の最終チェックが必要だとしても、すべての資料を人が最初から最後まで確認するのは容易ではありません。
今回の研究で、医師がフラッシュカード1件をレビューするのに要した時間の中央値は53秒でした。この速度で6000枚すべてを確認するには約88時間が必要になります。1日8時間ずつ確認しても、約11日かかります。
AIの自動処理も完璧ではありませんでした。生成されたフラッシュカードの一部は処理過程で問題が生じ、自動品質検査の結果自体が残りませんでした。
AIは短時間で膨大な教育資料を作る点に強みがあります。しかし全工程を任せると誤りが残り得ます。逆に、人が資料を一つ一つ作成して検査すれば、AIを使う効率が落ちます。
結局のところ鍵は、AIに任せる部分と、人が必ず確認すべき部分をどこで切り分けるかです。
研究チームが示した方向性は「ヒューマン・イン・ザ・ループ(Human-in-the-loop)」です。AIが処理する過程に専門家が関与し、重要な段階と最終結果を確認する方式です。AIが資料作成と一次検査を担い、実際の教育に使用する前に当該分野の専門家が最後に誤りをふるい落とす、といった形です。
キム・ナムグク教授は「生成AIを実際の教育現場で安全に活用するには、専門家の検証が不可欠であることを大規模研究で実証しました」としたうえで、「自動検証が見落とす誤りを体系的に管理し、安全基準を整備する研究を継続する必要があります」と話しました。
ナム・ユジン研究員は「生成AIが医療画像の教育資料を大量に作成できる可能性を確認すると同時に、作成された学習資料をそのまま使うのではなく、どの段階でどのような誤りが生じるのかを分析し、ふるい落とす過程が重要であることを示しています」と述べました。